128G 满血版 M5 Max Mac Studio 运行 Qwen3.8-Flash-Next 最佳实践报告
前段时间 Qwen 发布了 Qwen3.8-27B、Qwen3.8-flash-next 两个小模型,在 AA 的排行榜单上,甚至超过了了半年前的各家旗舰模型(比如 Opus 4.6、Kimi 2.6、GLM-5.2)
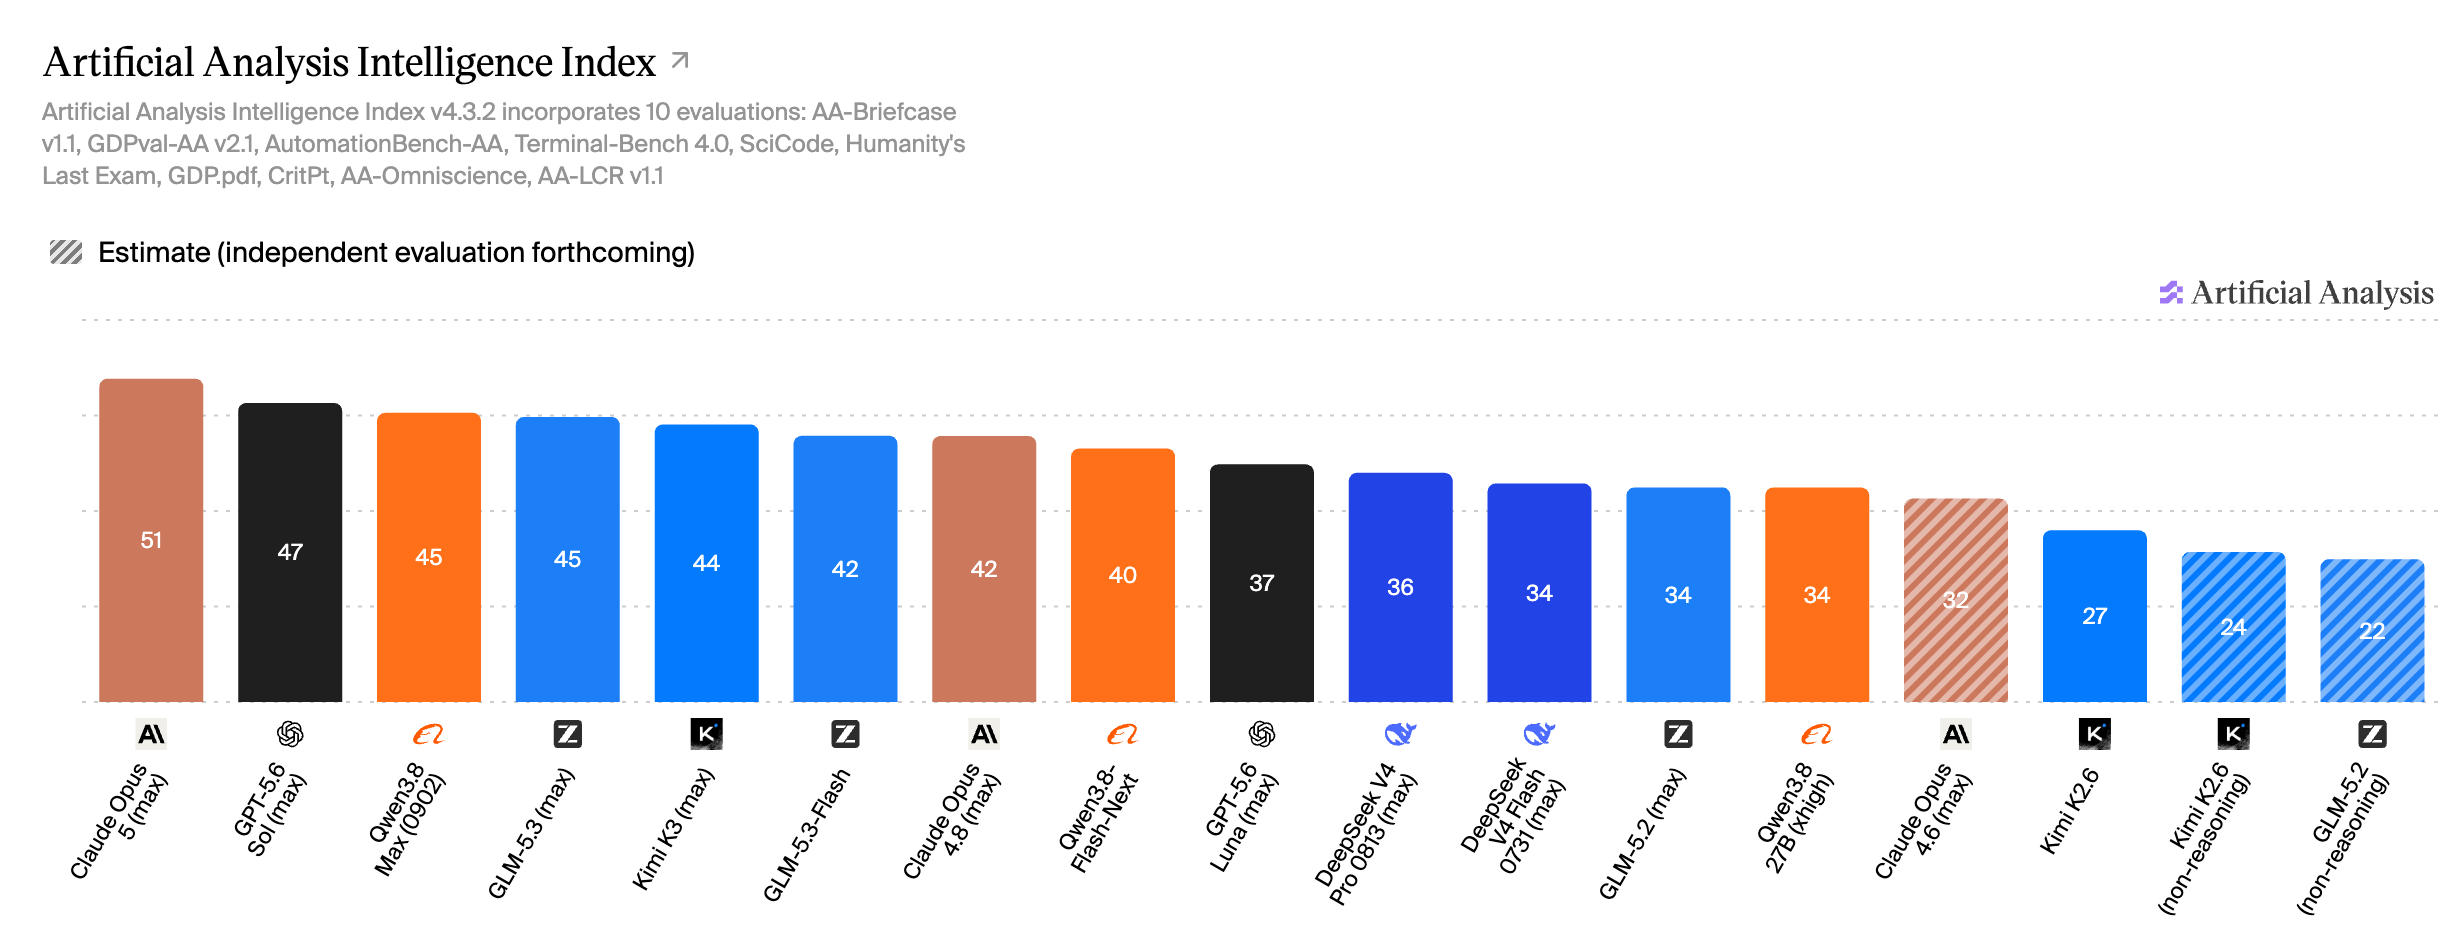
难道本地小模型真王朝了?!不过很遗憾我手上只有一台 4080s 的显卡,12G 显存只能勉强跑一跑 Qwen3.8-27B 的量化版,而且这种稠密模型的推理速度实在是感人。正巧 9 月苹果最新的 Mac Studio 要发布了,我必须得下一单尝尝咸淡(对不起买不起更贵的 M5 Ultra 了😭)
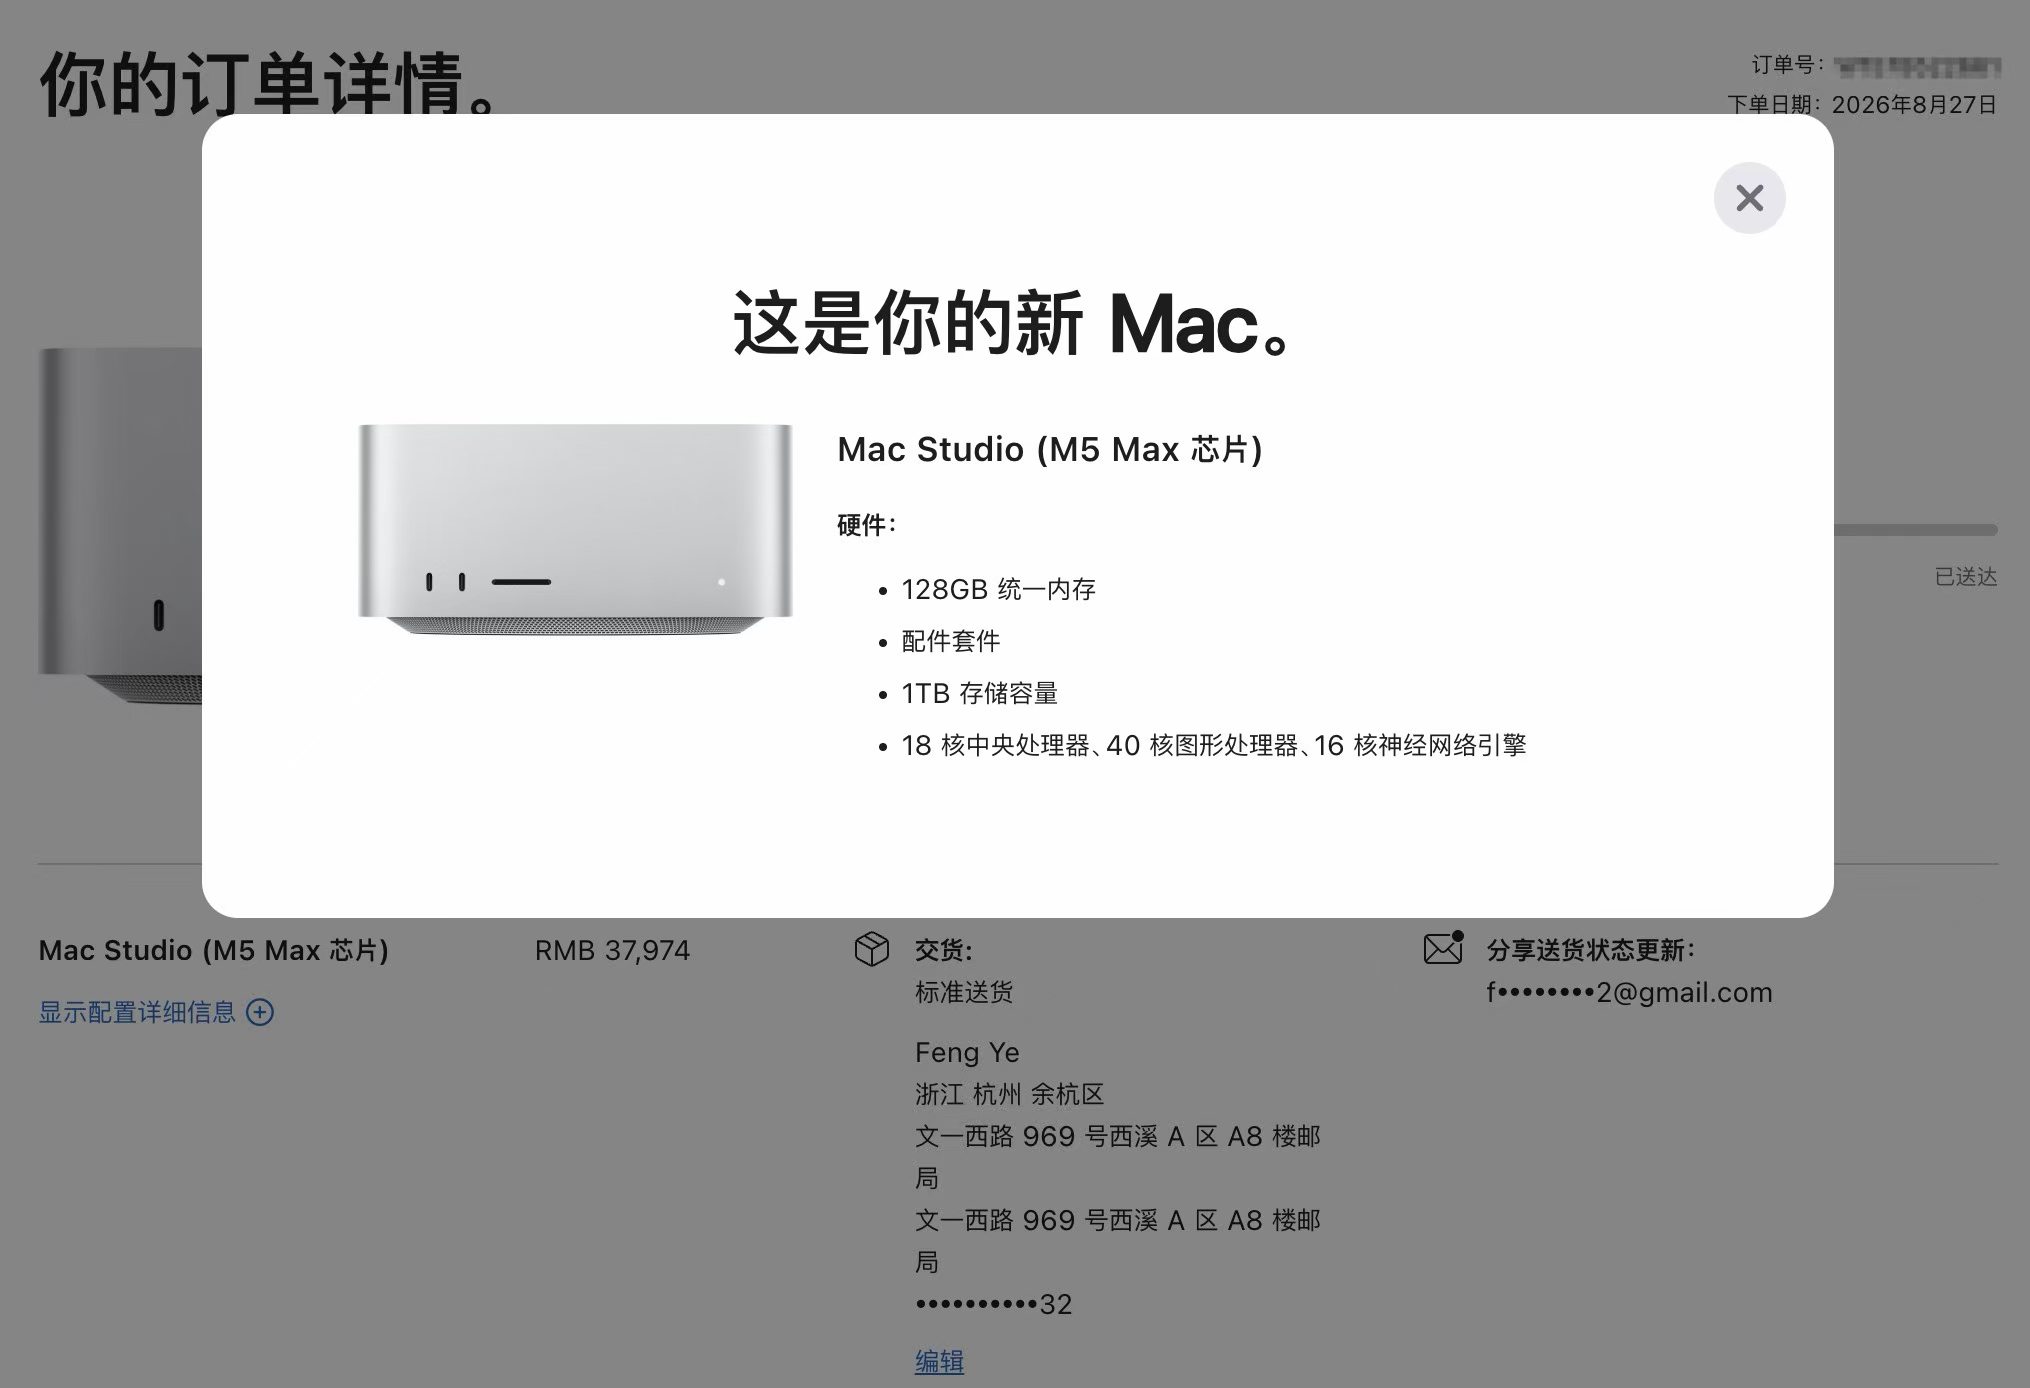
昨天到货后,马上迫不及待跑了一下 Qwen3.8-Flash-Next。这次我测试的两个目标是:
- **Qwen3.8-Flash-Next-REAP-288-MLX-4bit**:社区作者 sh0wie 提供的专家剪枝版本,每层保留 512 个专家中的 288 个,并使用 4-bit 量化。全套下载约 73.52 GB,主要优势是占用空间更小,下面简称 REAP。
- **Qwen3.8-Flash-Next-MLX-Serve-mixed-4-8bit**:社区作者 ddalcu 提供的混合量化版本,保留全部 512 个专家,专家权重主要使用 4-bit,Attention 等部分使用 8-bit。全套下载约 107.33 GB,配合 mlx-serve 运行,下面简称 mixed。
目前个人本地模型推理在成本上完全没有任何优势,如果不是为了学习研究,目前阶段不建议购买任何本地推理机器。
为什么我不买 DGX Spark?因为我认为 Mac Studio 的功耗更低,日常使用更舒服,且保值率更高,而且目前 DGX Spark 虽然有 CUDA 生态的优势,的统一内存带宽只有 273 GB/s,在 decode 时是一个短板,只能说未来提升空间很大,可以期待一下 DGX Spark 2代。
1. 模型部署
机器配置前面已经贴过了:18 核 CPU、40 核 GPU、128G 统一内存,系统是 macOS 27.0。两个模型对应的推理引擎如下:
| 模型 | 推理引擎 |
|---|---|
| REAP | mlx-vlm 0.7.6 / MLX 0.32.3 |
| mixed | mlx-serve 26.10.1 |
推理框架
这次优先选 MLX,是因为它针对 Apple Silicon 的 GPU 和统一内存做了专门优化,适合在 Mac 上跑量化大模型:
- Metal 量化算子:为量化矩阵乘法、矩阵与向量乘法提供专用 GPU 实现,按输入形状选择计算路径,覆盖 Prefill 和逐 token Decode。Metal 实现
- 统一内存:CPU、GPU 直接访问同一份数组,混合执行时减少数据复制和额外内存占用。统一内存设计
- 计算图优化:引擎使用
mx.compile时,可以合并重复计算、融合算子,减少中间结果的内存读写和执行开销。编译优化
这些优化直接服务于推理性能。再加上两个模型已有配套实现,量化权重、ngram 加载和 MTP 都可以沿用作者的方案;本文使用的 mlx-vlm、mlx-serve 负责具体的模型加载和推理服务。
Mac 上也有其他选择:
| 方案 | 特点 | 这次的取舍 |
|---|---|---|
| MLX + 配套推理引擎 | Apple Silicon 专用 Metal 算子、统一内存与计算图优化 | 优先使用原生优化,并沿用模型作者的配套实现 |
| llama.cpp | 支持 Metal 加速、GGUF 模型和多种量化精度,也支持 CPU/GPU 混合推理 | 换用它需要对应的 GGUF 权重,并核对这个模型的架构和 MTP 支持 |
| PyTorch + MPS | 通过 Metal 在 Apple GPU 上运行 PyTorch,适合沿用和修改 PyTorch 模型代码 | 量化算子和模型所需功能仍要逐项确认,不能把 CUDA 部署命令直接搬过来 |
llama.cpp 同样针对 Apple Silicon 做了 Metal 优化,PyTorch 也有 MPS 后端。具体谁更快取决于模型、量化格式和算子实现,本文没有做跨框架对照测速。
量化精度
按完整权重约 180B(含 ngram、MTP)估算,各档精度的体积如下:
| 权重精度 | 理论体积 |
|---|---|
| BF16 / FP16 | 360 GB |
| 8-bit | 180 GB |
| 6-bit | 135 GB |
| 4-bit | 90 GB |
以上为统一位数下的十进制 GB,未计量化元数据和运行开销;实际常驻内存还受 ngram 按需加载影响。模型组成
这次选 4-bit 为主的方案,给长上下文留出内存。mixed 的路由专家用 4-bit,Attention、共享专家和输出层等用 8-bit,路由器、归一化等保留 BF16;REAP 在 4-bit 量化之外进一步剪枝,换取更低的占用。mixed 精度配置 · REAP 剪枝说明
Ngram 表与内存映射
下载模型时会发现,里面还有一张很大的 ngram embedding 表。它根据相邻 token 的组合查出向量,mixed 版本将它单独放在 ngram_table.bin 中,光这一个文件就有约 32 GB。
如果把整张表都加载进内存,会挤掉不少留给上下文和其他应用的空间。这次两个模型都用了 mmap(内存映射):文件放在 SSD 上,用到哪部分就读取哪部分,读过的文件页由 macOS 缓存。这样就不用让整张表始终常驻内存。
| 配置 | REAP | mixed |
|---|---|---|
| ngram 加载方式 | ple_storage,SSD mmap |
ngram_table.bin,SSD mmap |
| 相关设置 | cache_rows=0 |
关闭 ple-gpu,设置 MLX_SERVE_NGRAM_WARM=0 |
| MLX 缓存上限 | 4 GiB | 8 GiB |
MLX_SERVE_NGRAM_WARM=0 是关闭整表后台预热,避免主动把整张表读进系统缓存。mmap 仍然会占用一部分内存,只是文件页可以由系统按需回收。
MTP 推测解码
这次还分别测了开启和关闭 MTP(Multi-Token Prediction,多 token 预测)的情况。它在这里用于推测解码:先由预测模块提出后面几个 token,再交给主模型验证。如果一次能接收多个 token,就有机会比逐个生成更快。
不过,预测和验证也有开销,所以开了不一定更快。REAP 还需要额外加载约 5.24 GB 的预测模型(drafter),mixed 的模型包里已经带了对应权重。后面我们直接看两种模式的速度差别。
整理文章时,mixed 作者已经推荐新的 iQ 版本,旧包停止更新。下面的数据对应这次实际测过的 mixed-4-8bit,新版还没有在本机复测。
2. 内存占用
先看内存。测速时活动监视器里 REAP 的 Python 进程大约占 49 GB,比下载下来的文件小不少。前面说的 ngram 按需加载就是原因之一,所以不能直接用模型文件大小来判断运行时占用。
下面是整个测速过程中,MLX 记录到的最高内存分配量:
| 方案 | MLX 最高分配量 |
|---|---|
| REAP | 55.46 GB |
| REAP + MTP | 60.68 GB |
| mixed | 80.64 GB |
| mixed + MTP | 84.30 GB |
这轮始终只加载一个大模型、处理一个请求,两套方案都能跑完接近 256K 的输入。mixed 普通模式最高约 81 GB,开 MTP 后约 84 GB;REAP 则分别约 55 GB 和 61 GB,能给其他应用多留一些空间。
这些数值不包含整机所有占用,也不能和活动监视器里的进程内存直接相加。测试期间没有采样到新增的 Swapouts(内存换出)记录;如果还要同时开其他模型或应用,就要另外留出余量。
3. 推理性能
我平时会用到 200K 左右的上下文,所以这次没有只测几百个 token,而是从 512 一直测到了接近 256K,看看输入变长后会掉多少速度。
测试方法
输入分为八档:512、4,096、16,384、32,768、65,536、131,072、200,000 和 261,632 token。最后一档给 262,144 token 的窗口留了一部分输出空间,下面简称 256K 档。
中文、英文取固定的 Wikipedia 文本,代码取 CPython 3.12.0 标准库源码,按需要的长度截取。每份输入前、中、后各放一个校验码,让模型先找出来,再分析内容,顺便检查长输入里的信息能不能被读到。
两个模型各测普通模式和 MTP 模式,32K 及以下重复三次,64K 及以上重复两次,共 240 个独立测试项。每次最多输出 256 token,temperature=0,关闭思考和前缀缓存;输入按每批 1,024 token 处理,也就是 prefill chunk=1024。
这里先区分一下 Prefill 和 Decode:把一大段内容发给模型后,模型要先处理这些输入,这一步叫 Prefill;随后开始往外生成回答,叫 Decode。表里的 tok/s 就是每秒处理或生成的 token 数。
所以看长上下文性能,要同时看多久开始回答,以及开始后输出多快。只看 Decode,很容易忽略前面处理长文的等待时间。
测试结果
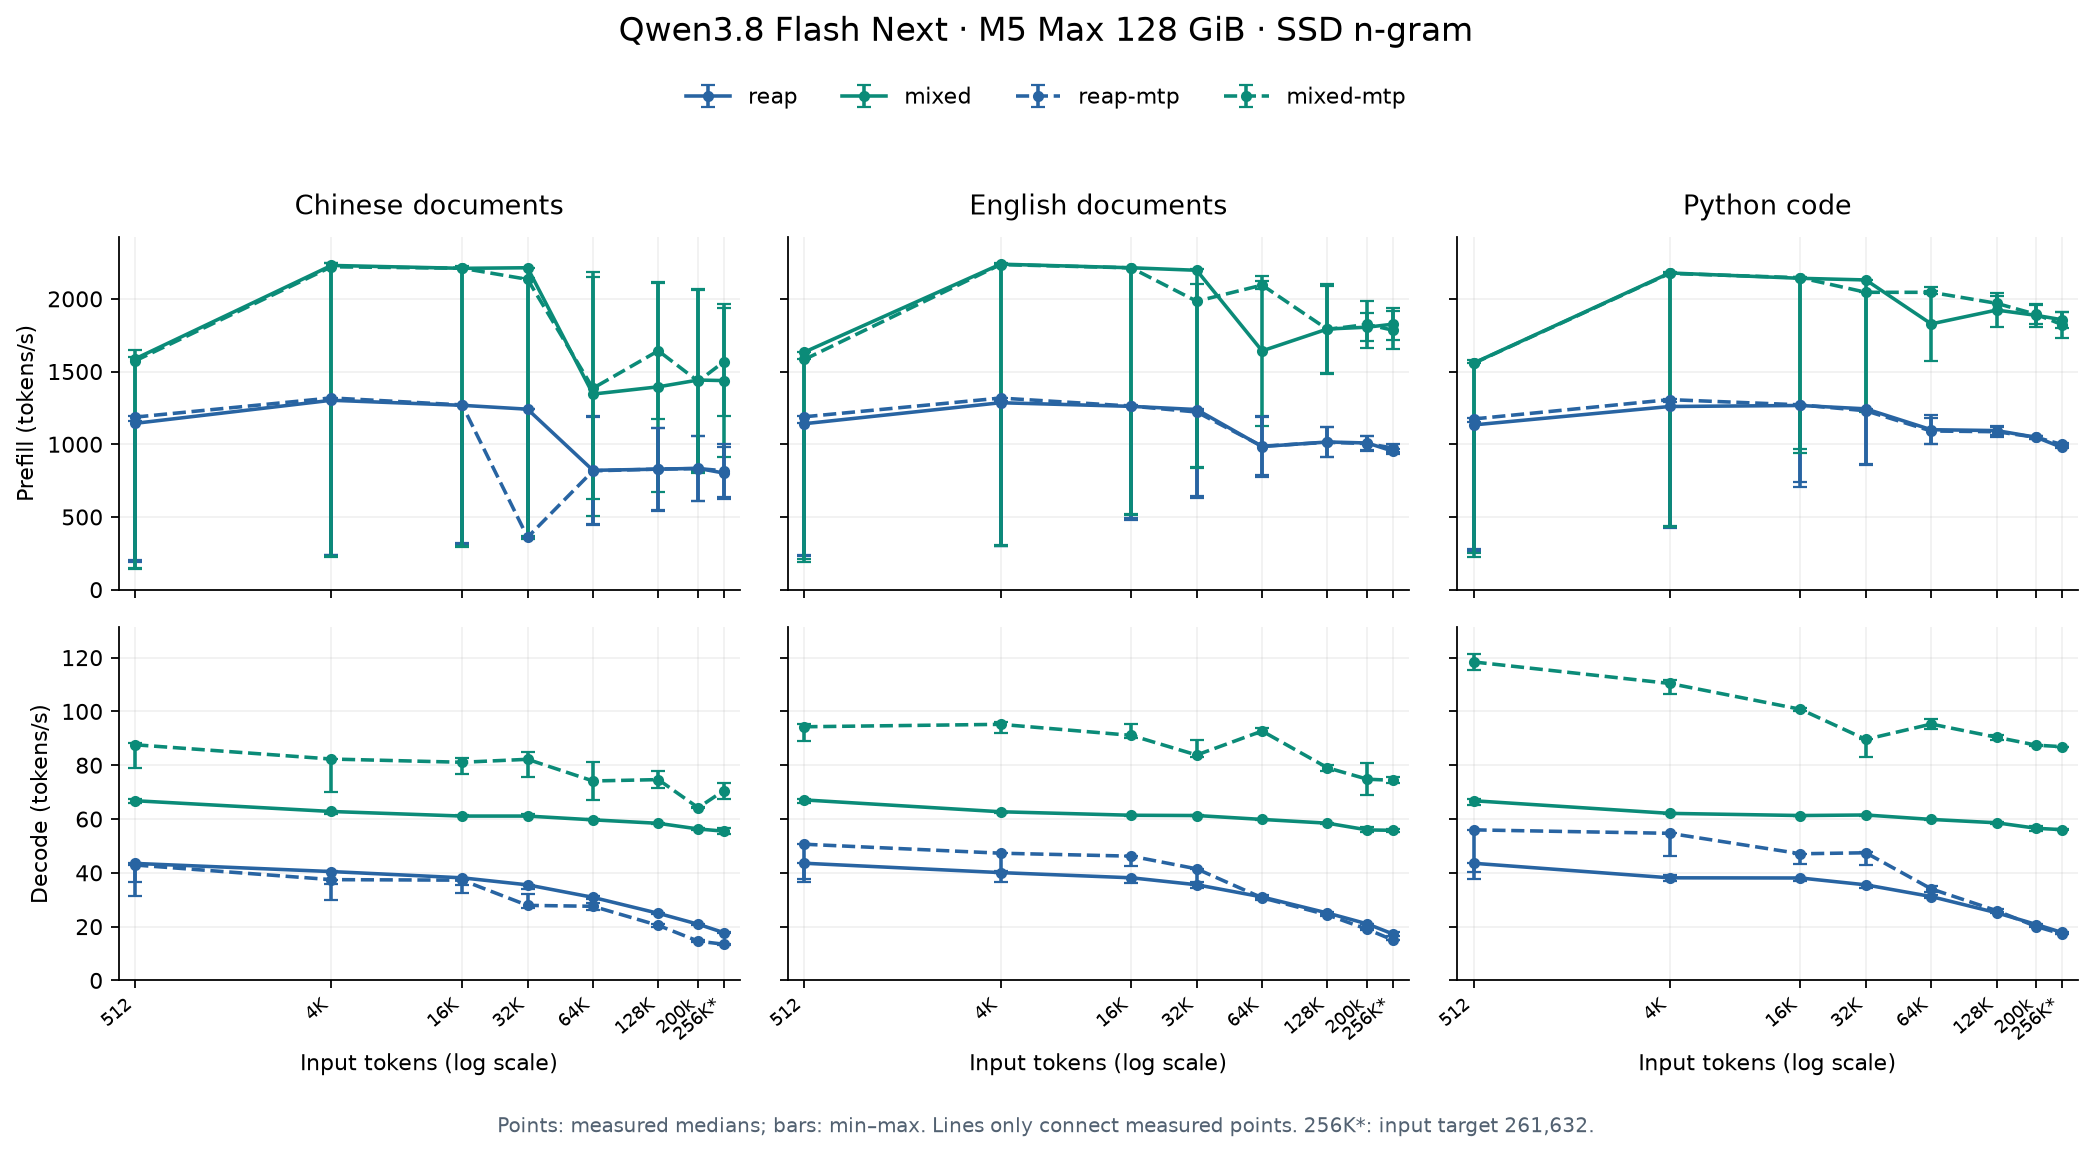
图中实线是普通模式,虚线是 MTP,误差棒表示各轮的最小值到最大值。下面列出全部八档结果,数值取同一档中文、英文、代码全部轮次的中位数。首 token 时间从发出请求开始计算,也包含分词等开销。
| 输入档位 | 方案 | Prefill(tok/s) | Decode(tok/s) | 首 token 时间(秒) |
|---|---|---|---|---|
| 512 | REAP | 1,141.3 | 43.5 | 0.5 |
| 512 | REAP + MTP | 1,177.3 | 42.9 | 0.4 |
| 512 | mixed | 1,580.5 | 66.8 | 0.3 |
| 512 | mixed + MTP | 1,557.5 | 94.3 | 0.3 |
| 4K | REAP | 1,285.6 | 39.3 | 3.2 |
| 4K | REAP + MTP | 1,308.5 | 46.1 | 3.1 |
| 4K | mixed | 2,183.5 | 62.4 | 1.9 |
| 4K | mixed + MTP | 2,175.9 | 95.2 | 1.9 |
| 16K | REAP | 1,262.7 | 38.1 | 13.0 |
| 16K | REAP + MTP | 1,268.2 | 43.1 | 12.9 |
| 16K | mixed | 2,144.0 | 61.3 | 7.6 |
| 16K | mixed + MTP | 2,147.3 | 91.1 | 7.6 |
| 32K | REAP | 1,241.2 | 35.5 | 26.4 |
| 32K | REAP + MTP | 1,221.9 | 41.5 | 26.9 |
| 32K | mixed | 2,131.0 | 61.3 | 15.4 |
| 32K | mixed + MTP | 2,045.1 | 83.8 | 16.0 |
| 64K | REAP | 1,096.9 | 31.0 | 60.3 |
| 64K | REAP + MTP | 1,091.2 | 30.7 | 60.6 |
| 64K | mixed | 1,827.6 | 59.8 | 36.6 |
| 64K | mixed + MTP | 2,060.7 | 92.7 | 31.8 |
| 128K | REAP | 1,086.9 | 25.1 | 120.8 |
| 128K | REAP + MTP | 1,083.8 | 24.4 | 121.2 |
| 128K | mixed | 1,922.8 | 58.4 | 68.5 |
| 128K | mixed + MTP | 1,969.2 | 79.0 | 66.6 |
| 200K | REAP | 1,047.5 | 20.9 | 191.2 |
| 200K | REAP + MTP | 1,044.9 | 19.0 | 191.6 |
| 200K | mixed | 1,855.5 | 56.3 | 108.0 |
| 200K | mixed + MTP | 1,892.6 | 74.8 | 105.9 |
| 256K | REAP | 970.8 | 17.8 | 269.8 |
| 256K | REAP + MTP | 995.1 | 15.1 | 263.2 |
| 256K | mixed | 1,856.5 | 56.0 | 141.1 |
| 256K | mixed + MTP | 1,823.3 | 74.5 | 143.9 |
长上下文下,mixed 的优势比较明显。普通模式在 200K 和 256K 两档都能保持约 56 tok/s,REAP 则降到了约 21 和 18 tok/s。mixed 处理输入也更快:200K 输入约等 108 秒开始回答,REAP 约等 191 秒。
不过,256K 输入即使用 mixed,也要等约 141 秒才开始输出。这次关掉了前缀缓存,每次都得重新处理整段输入;日常多轮对话如果能复用历史缓存,等待时间需要另外测,不能直接套这张表。
MTP 性能对比
mixed 在 200K 档从 56.3 提升到 74.8 tok/s,约快了 33%,256K 档也差不多。但首 token 时间基本没变,也就是说,它主要加快的是开始回答之后的输出速度。
REAP 的结果正好相反:两个长输入档位都变慢了,还多占了约 5 GB 内存。按这轮结果,mixed 可以开 MTP 试试,REAP 跑长上下文时就保持普通模式。
我还对比了相同输入下的首轮完整回答。REAP 开关 MTP 的 24 份回答全部逐字一致,mixed 只有 3 份一致。输出不同不等于质量下降,不过如果需要复现普通模式的回答,就不要在两种模式之间切换。
附:测试配置
硬件环境
| 项目 | 配置 |
|---|---|
| 机器 | Mac Studio,Apple M5 Max |
| CPU / GPU | 18 核 / 40 核 |
| 统一内存 | 128 GiB |
| 系统 | macOS 27.0 |
引擎配置
| 项目 | REAP | mixed |
|---|---|---|
| 模型 | sh0wie/Qwen3.8-Flash-Next-REAP-288-MLX-4bit | ddalcu/Qwen3.8-Flash-Next-MLX-Serve-mixed-4-8bit |
| 固定版本 | 668f31b | 3191916 |
| 引擎版本 | mlx-vlm 0.7.6 / MLX 0.32.3 | mlx-serve 26.10.1 |
| Ngram 加载 | SSD mmap,ple_storage |
SSD mmap,ngram_table.bin |
| Ngram 设置 | cache_rows=0 |
关闭 ple-gpu,MLX_SERVE_NGRAM_WARM=0 |
| MLX 缓存上限 | 4 GiB | 8 GiB |
| MTP | 关闭、开启各测一轮完整档位 | 关闭、开启各测一轮完整档位 |
测试参数
| 项目 | 设置 |
|---|---|
| 同时加载模型 / 并发请求 | 1 / 1 |
| 目标输入长度(token) | 512、4,096、16,384、32,768、65,536、131,072、200,000、261,632 |
| 上下文窗口 | 262,144 token |
| 最大输出长度 | 256 token |
| Temperature / Seed | 0 / 42 |
| 思考模式 / 前缀缓存 | 关闭 / 关闭 |
| Prefill 分块 | 1,024 token |
| 重复次数 | 32K 及以下每项 3 次,64K 及以上每项 2 次 |
| 独立测速项 | 240 项 |
| 服务重启 | 每个上下文批次重启 |
| 系统文件缓存 | 不强制清空 |
| 中文语料 | Wikimedia Wikipedia 20231101.zh,前 100 条训练文本 |
| 英文语料 | Wikimedia Wikipedia 20231101.en,前 100 条训练文本 |
| 代码语料 | CPython v3.12.0,Lib/*.py 按路径排序,排除 test 目录 |