手把手带工程同学从零实现一个完整的LLM(CS336)——预训练篇
手把手带工程同学从零实现一个完整的LLM(CS336)——预训练篇
前言
上一篇我们实现了 Tokenizer 和 Transformer,从一段文本到每个位置的词表分数,整个前向计算已经串起来了。不过模型里的参数还是随机初始化的,直接拿来生成文本,出来的也基本是乱码。
这一篇继续把训练部分补上:准备输入和标签,计算 loss,用优化器更新参数,最后加载训练好的模型生成文本。对应的是 CS336 Assignment 1 剩下的内容。
这里做的是预训练:让模型在大量文本上学习预测下一个 token。训练数据本身就能提供答案,比如输入“今天的天气”,让模型预测后面的字,不需要逐条人工标注。训练完成后,我们得到的是一个能续写文本的基础模型;指令微调、偏好优化这些后训练内容,后面再写。
下面继续使用上一篇的 TransformerLM,在 Mac Studio 上完成 TinyStories 和 OpenWebText 的训练,再比较学习率、batch size 和模型结构对结果的影响。
1. 训练目标
输入和标签
先看一个最简单的例子。假设一段文本编码之后是:
1 | 原始序列:[12, 35, 8, 91, 6] |
标签就是把输入往后移动一个位置。模型在第一个位置预测 35,第二个位置预测 8,依次往后。
上一篇实现的 causal mask 保证了当前位置只能看见自己和前面的 token。因此,我们可以一次把整段输入交给模型,并行计算所有位置的预测结果。这里用到的上下文都来自原始文本,训练时不需要等模型生成一个 token 后再算下一个。
输入和标签的形状都是 (batch_size, seq_len),模型输出的 logits 是 (batch_size, seq_len, vocab_size)。接下来要做的,就是衡量每个位置预测得怎么样。
Cross-Entropy
对于某一个位置,假设 logits 是向量
这里就是交叉熵损失(Cross-Entropy)。正确 token 的概率是 0.1 时,loss 约为 2.30;概率提高到 0.8,loss 就降到了约 0.22。一个 batch 的 loss,是所有位置的 loss 取平均。
实现时,把上面的 softmax 代进去:
这样不用先算出概率,再取对数。为了避免指数运算溢出,再让所有 logits 减去这一行的最大值
减去相同的数不会改变 softmax 的结果,但最大的指数项变成了
1 | import torch |
gather 取出每个位置上正确 token 对应的分数,最后的 mean() 同时对 batch 和序列位置取平均。这里先转成 float32 做 loss 计算,保留反向传播所需的计算图。
Perplexity
评估语言模型时还经常看到困惑度(Perplexity,PPL)。它和这里的平均交叉熵关系很直接:
比如 loss 为 2,PPL 约为 7.39。也可以把它理解成:模型给正确 token 分配的概率,其几何平均值的倒数。概率越高,PPL 越低。
比较 PPL 时,要使用同一份评估数据和同一个 tokenizer。换一个 tokenizer,文本会被切成不同数量的 token,平均到每个 token 上的 loss 也会变化。
2. 优化器
SGD
上一篇讲线性回归时,我们已经用过梯度下降。把所有模型参数记作
对应到 PyTorch,训练的主体还是这几行:
1 | optimizer.zero_grad(set_to_none=True) |
backward() 计算梯度,结果保存在参数的 .grad 上;step() 才真正更新参数。PyTorch 默认会累加梯度,所以每一步开始时要先清空。
学习率过大会怎样,可以直接拿一个二次函数试一下。对于一个有 100 个数的参数矩阵,令 loss 为所有元素平方的平均值,那么每个参数
只看第一次更新:lr=10 时参数变成原来的 0.8 倍;lr=100 时变成 -1 倍,loss 暂时不变;lr=1000 时变成 -19 倍,loss 直接放大到 361 倍。再用 5 * torch.randn(10, 10) 初始化参数,固定种子为 42,实际更新 10 次:
| 初始学习率 | 更新前 loss | 10 次更新后 loss |
|---|---|---|
| 1 | 24.17 | 19.75 |
| 10 | 24.17 | 2.85 |
| 100 | 24.17 | 约 |
| 1000 | 24.17 | 约 |
10 比 1 降得快;100 在第 4 次更新时,上面括号里的系数恰好变成零,所以 loss 几乎归零;1000 则一路增大。这是这个二次函数上的结果,训练 Transformer 时还要重新找学习率。
AdamW
训练 Transformer 时,这里使用 AdamW。它会为每个参数额外保存两个和参数同样形状的张量,分别记作
第一个记录梯度的移动平均:
第二个记录梯度平方的移动平均:
这里的平方是逐元素计算。
因为
1 开始。参数更新分为两步,先做 weight decay:
再用梯度的移动平均更新:
第一步让参数按比例向零收缩,
按这个顺序实现:
1 | import math |
self.state 保存每个参数的步数和两个移动平均,param_groups 则允许不同参数组使用不同的学习率、weight decay。这里先按所有参数采用相同配置来写,参数和优化器状态都使用 float32。
学习率调度
训练过程中,学习率也会变化。这里使用 warmup 加余弦衰减:先从零逐渐增加到最大学习率,再缓慢降到最小值。
设 warmup 持续
之后进入余弦衰减:
超过
1 | def cosine_lr(t, max_lr, min_lr, warmup_steps, total_steps): |
训练循环每一步把返回值写进优化器的 lr。这里调度步数从 0 开始,AdamW 内部用于偏差修正的计数从 1 开始,两者用途不同。
梯度裁剪
某个 batch 可能产生特别大的梯度。更新前,可以先限制梯度的整体长度,避免这一步把参数推得太远。
把所有参数的梯度看成一个长向量,它的长度是:
这里双竖线表示 L2 范数。给定上限
这个操作就是梯度裁剪(Gradient Clipping)。它保持梯度方向,限制更新前的梯度大小。
1 |
|
这里算的是所有参数合在一起的范数,不能给每个参数分别裁剪。调用位置在 loss.backward() 之后、optimizer.step() 之前。返回裁剪前的范数,后面可以记到日志里。
3. 训练循环
数据加载
先用上一篇的 tokenizer,把训练文本和验证文本分别编码成 token ID。多篇文档之间保留 <|endoftext|>,编码后顺序写入二进制文件。
词表有 10,000 个 token 时,每个 ID 用 uint16 就能存下。文件比较大,可以用 numpy.memmap 按需读取,避免启动时把所有 token 拷贝到内存:
1 | import numpy as np |
这里的 .bin 是无文件头的原始数组,写入和读取时 dtype 必须一致。保存数据时也要一起记录使用的 tokenizer 和 dtype;如果 ID 超出 uint16 的范围,就要改用 uint32。训练集和验证集使用同一个 tokenizer,BPE 只在训练集上训练。
每次随机选 batch_size 个起点,每个起点取 seq_len + 1 个 token,就能得到前面那组错开一位的输入和标签:
1 | def get_batch(data, batch_size, seq_len, device, rng): |
磁盘上用紧凑的整数格式保存,取出一个 batch 后再转换成 PyTorch 使用的 long。这里直接从 token 流中抽固定长度的窗口,不需要 padding;窗口可能跨过文档分隔符。
Checkpoint
训练中断后要能继续,就得保存当前状态。最基本的是模型参数、优化器状态,以及已经完成的训练步数:
1 | def save_checkpoint(path, model, optimizer, step): |
只恢复模型参数,AdamW 的
上面足够接着训练。如果希望恢复后连抽到的 batch 都一致,还需要保存 NumPy 和 PyTorch 的随机数状态。模型配置、tokenizer 版本也应和 checkpoint 放在一起,避免后来拿错词表。
验证 loss
训练 loss 反映当前 batch 的情况。我们还要定期从验证集取数据,检查模型在没参与参数更新的文本上表现如何:
1 |
|
eval() 切换模型的运行模式,no_grad() 关闭梯度记录。这里每个 batch 的 token 数相同,可以直接平均;如果长度不同,就要按 token 数加权。
固定抽样窗口适合日常观察曲线,最终汇报时再用更充分的验证集评估,避免只盯着一小部分样本。
完整循环
数据、loss 和优化器都有了,就可以接回上一篇的模型。下面沿用现有实现里的构造参数名 nums_layer,训练配置里的 num_layers 传给它。
1 | from cs336_basics.model import TransformerLM |
device 根据机器设为 "cuda"、"mps" 或 "cpu"。学习率 1e-3 先作为实验起点,后面还要调。
1 | import json |
调用时,把前面打开的两个 token 数组传进去即可:
1 | train(model, optimizer, train_tokens, val_tokens, device, "runs/baseline") |
这几步的顺序是固定的:取数据 → 前向计算 → 计算 loss → 反向传播 → 裁剪梯度 → 更新参数。验证和保存 checkpoint 穿插在循环中。
日志同时记录 step 和时间。step 用来看收敛过程,时间用来看同样的训练效果花了多久。这里的 seconds 是本次进程的累计耗时,包含验证和保存开销;恢复训练后会重新计时。train_loss 是当次 batch 的值,画图时可以再做滑动平均。
正式开始前,先固定一个小 batch,重复训练它。正常情况下,模型应该能把这批数据的 loss 压得很低。如果连这一点都做不到,优先检查标签有没有错位、梯度有没有传回来、优化器有没有更新参数。
4. 训练资源核算
上一篇算过前向传播的参数量和 FLOPs。训练还要保存梯度、优化器状态,以及反向传播要用到的中间结果。
这里沿用
参数和优化器状态
无偏置、输入输出权重不共享时,参数量为:
我们先计算和 batch size 无关的部分。所有张量使用 float32,每个元素占 4 字节:
| 内容 | 元素数量 | 内存 |
|---|---|---|
| 模型参数 | ||
| 参数梯度 | ||
| AdamW 的 |
||
| 合计 |
比如 TinyStories 的配置 V=10000, D=512, L=4, d_ff=1344,总参数量约为 22.70M。上述三部分合起来约 363 MB,还没有算激活值和临时张量。这里和下面的 GB、MB 都按十进制计算。
激活值
接下来计算随 batch 增长的部分。我们用一个简单的记账方式:把主要算子的输出都计入激活值,不考虑张量复用和算子融合。
每个 Block 中,各部分的元素数是:
| 计算 | 输出元素数 |
|---|---|
| 两次 RMSNorm | |
| Q、K、V 投影 | |
| Attention 加权求和与输出投影 | |
| SwiGLU 的两个升维投影、SiLU、逐元素乘法 | |
| SwiGLU 降维投影 |
加上最后的 RMSNorm、词表投影,以及按一个词表大小张量估算的交叉熵中间结果,得到:
训练内存的粗略估计就是
代入上一篇 GPT-2 XL 规模的配置,V=50257, D=1600, L=48, H=25, S=1024, d_ff=4288,可以算出:
按这个估算,80 GB 可以放下 B=3,B=4 就超过了。实跑还要给额外开销留空间。式子里的
计算量和训练时间
一次 AdamW 更新主要是对每个参数做移动平均、开方、除法和加减。按未融合的标量公式展开,更新
只计算主要矩阵乘法时,一条长度为
反向按前向的两倍估算,一步训练约为
比如按 GPT-2 XL 规模、batch_size=1024、训练 400000 步,单条序列前向约 3.52 TFLOPs。假设设备峰值是 495 TFLOP/s,实际能达到其中的 50%,计算时间约为 4850 小时,也就是 202 天,尚未计入数据读取、验证和保存。这是假设能执行该计算的吞吐估算;这个 batch 无法直接装进前面那张 80 GB 卡,需要梯度累积等方式拆开处理。
这里的 50% 对应模型 FLOPs 利用率(MFU)。它衡量模型实际吞吐对应的计算量占理论峰值的比例,和监控工具显示的 GPU 忙碌百分比含义不同。
5. 文本生成
训练时,所有位置都有正确的下一个 token。生成时,我们只有用户给的开头,需要把模型刚生成的 token 接回输入,再继续预测。
Temperature
每次取最后一个位置的 logits,除以温度
T=1 使用原来的分布。温度降低,概率更集中在高分 token 上;温度升高,低分 token 也更容易被抽到。T=0 单独处理,直接选择分数最高的 token,也就是贪心解码。
Top-p
还可以按概率从大到小排序,只保留累计概率达到
比如排序后的概率是 [0.50, 0.25, 0.15, 0.10],p=0.8 时要保留前三个 token,因为前两个加起来只有 0.75。让累计概率首次越过阈值的那个 token 也要保留。
1 |
|
返回结果包含原来的 prompt。用 tokenizer 的 decode() 就能转回文本。eos_id 要取同一个 tokenizer 中 <|endoftext|> 对应的 ID,不能写死成别的模型使用的编号。
这里每一步都重新计算整个输入窗口,超过上下文长度时只保留最近的一段。先把生成流程跑通,后面讲推理优化时,再加入 KV Cache 来复用历史计算。
6. 训练实验
实现完成后,还要看看这些模块放在一起,能不能正常学到东西。下面先用 TinyStories 跑通训练,再做调参、结构消融和 OpenWebText 实验。
训练都在 Mac Studio 上执行。除单独注明的改动外,各组沿用同一配置和随机种子;耗时包含定期验证与中途保存,不含数据准备和训练结束后的完整验证。机器上保留了原有服务,耗时用于观察本次实验的开销。
TinyStories
TinyStories 是一个由短篇英文故事组成的数据集,词汇和句式相对简单,适合先用小模型验证训练流程。
基础模型配置如下:
| 参数 | 配置 |
|---|---|
| vocab_size | 10,000 |
| context_length | 256 |
| d_model | 512 |
| d_ff | 1,344 |
| num_layers | 4 |
| num_heads | 16 |
| RoPE theta | 10,000 |
训练预算用处理过的 token 数来算:
128 × 10000 × 256 = 327680000,约 3.28 亿 token。算力有限时,可以先用前面代码中的 32 × 5000 × 256 = 40960000,约 4096 万 token。这里统计的是累计处理量,同一段文本可能被多次抽到。
完整预算下,作业给出的 TinyStories 验证 loss 目标是 1.45;低资源配置放宽到 2.00。下面按低资源配置完成实验。
这次先在 Mac Studio 上跑一轮基线,使用上面的 4096 万 token 预算。数据是 TinyStories V2 GPT-4 版本,BPE 只用训练集前 10,000 篇故事训练,词表大小为 10,000,再用这份 tokenizer 编码完整训练集和验证集。每篇故事末尾加入 <|endoftext|>,编码结果用 uint16 保存。
| 项目 | 本次配置 |
|---|---|
| 机器 | Mac Studio,M5 Max,128 GB 统一内存 |
| 运行环境 | macOS 27.0.1,Python 3.12.14,PyTorch 2.11.0,MPS,float32 |
| 模型参数量 | 22,696,448,输入 Embedding 与输出层不共享权重 |
| 训练集 / 验证集 | 542,033,426 / 5,473,838 个 token |
| Batch / 序列长度 / 步数 | 32 / 256 / 5,000 |
| 学习率 | 100 步 warmup,峰值 1e-3,余弦衰减到约 1e-4 |
| AdamW | betas=(0.9, 0.95),eps=1e-8,weight_decay=0.1 |
| 梯度裁剪 | 全局梯度范数上限 1.0 |
| 随机种子 | 训练 42,抽样验证 2026 |
| 验证和保存 | 每 100 步验证,每 1,000 步保存 checkpoint |
训练时从完整训练集随机抽窗口;每次验证使用固定的 20 个 batch,共 163,840 个 token。
这轮训练用了约 17 分 39 秒,包含定期验证和中途保存 checkpoint 的时间,不含数据准备。曲线如下:
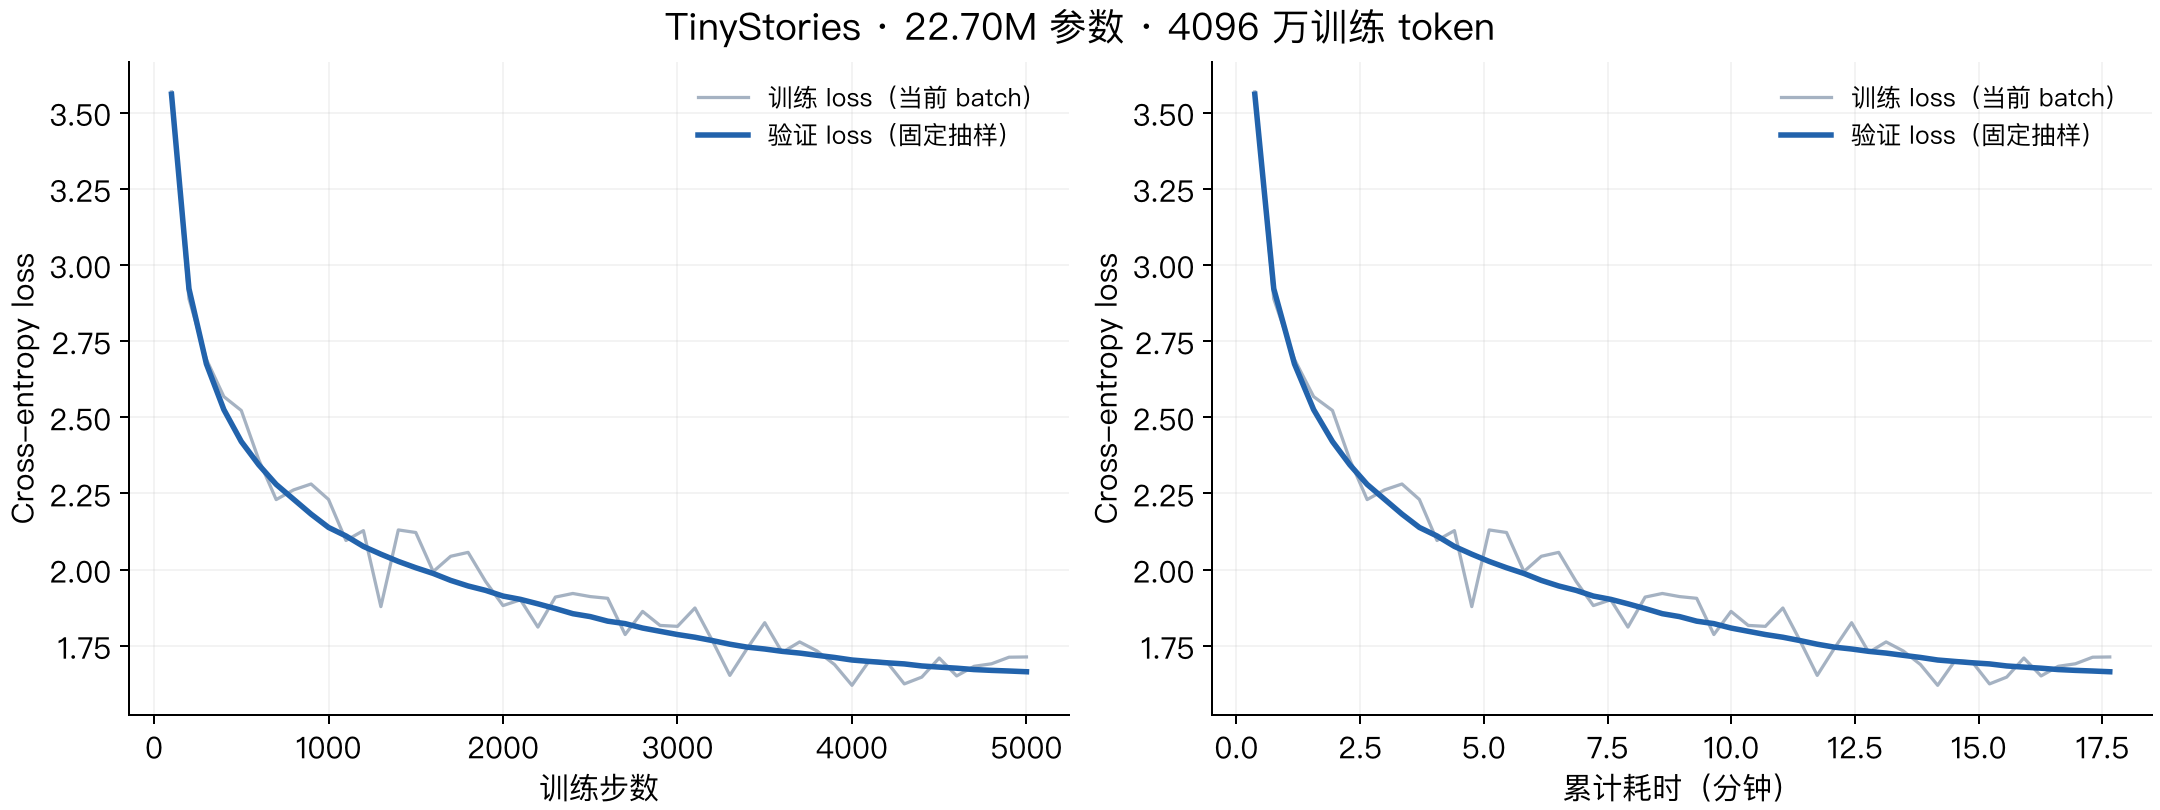
| 训练步数 | 累计训练 token | 抽样验证 loss |
|---|---|---|
| 100 | 819,200 | 3.561 |
| 1,000 | 8,192,000 | 2.139 |
| 2,000 | 16,384,000 | 1.913 |
| 3,000 | 24,576,000 | 1.787 |
| 4,000 | 32,768,000 | 1.703 |
| 5,000 | 40,960,000 | 1.665 |
训练 loss 记录的是当前 batch,因此有上下波动;验证集的抽样窗口固定,更适合看整体变化。
训练结束后,再把验证集按 256 个 token 切成不重叠的窗口,丢弃末尾不足一窗的部分,总共评估 5,473,792 个 token。得到验证 loss 1.673,对应 PPL 5.33。这轮已经低于低资源配置的 2.00 目标;这里的数值对应上面这份 tokenizer 和评估方式。
生成样例
下面用最后一步的模型,接着同一个开头往下写。最多生成 256 个新 token,遇到 <|endoftext|> 停止,随机种子固定为 42。
贪心解码,temperature=0:
Once upon a time, there was a little girl named Lily. She loved to play with her toys and have fun. One day, she found a big, shiny rock in her yard. She was very happy and wanted to show it to her mom.
Lily ran to her mom and said, “Look, Mom! I found a shiny rock!” Her mom smiled and said, “That’s a very special rock, Lily. It’s very special to me.”
Lily wanted to show her mom the shiny rock, so she ran to her mom. Her mom said, “Lily, you can keep the shiny rock. It’s very special to me.” Lily was very happy and thanked her mom.
From that day on, Lily always remembered to keep her room clean and shiny. She knew that her mom would always be there to keep her room clean and safe. And she always remembered to keep her room clean and tidy.
<|endoftext|>
随机采样,temperature=0.8、top-p=0.9:
Once upon a time, there was a little girl named Lily. She loved to play outside with her ball. One day, she saw a big, heavy rock. She had an idea. She wanted to climb the rock and see what was on the other side.
Lily started to climb the rock. She went very fast. But then, she got stuck on the rock. She felt sad and scared. She started to cry. Her mom heard her cry and came to help her. She helped Lily get down from the rock.
Her mom tried to help Lily. Together, they pushed and pushed. The rock moved and Lily got to the top of the rock. Lily was so happy. She said, “Thank you, Mom!” They both smiled and hugged. From that day on, Lily always helped her mom when she needed it.
<|endoftext|>
两份输出已经能写出完整的英文故事,但内容还有问题。贪心解码后半段反复说保持房间整洁,和前面捡石头的情节接不上;随机采样里,妈妈刚把 Lily 救下来,后面又写她爬到石头顶上。loss 降下来了,故事里的重复和前后矛盾还需要继续观察。
学习率
先固定模型和 batch,把最大学习率设为 3e-4、1e-3、3e-3、1e-2,每组训练 1,000 步,也就是 819.2 万 token。warmup 占总步数的 2%,最低学习率是最高值的 1/10,其他设置一致。
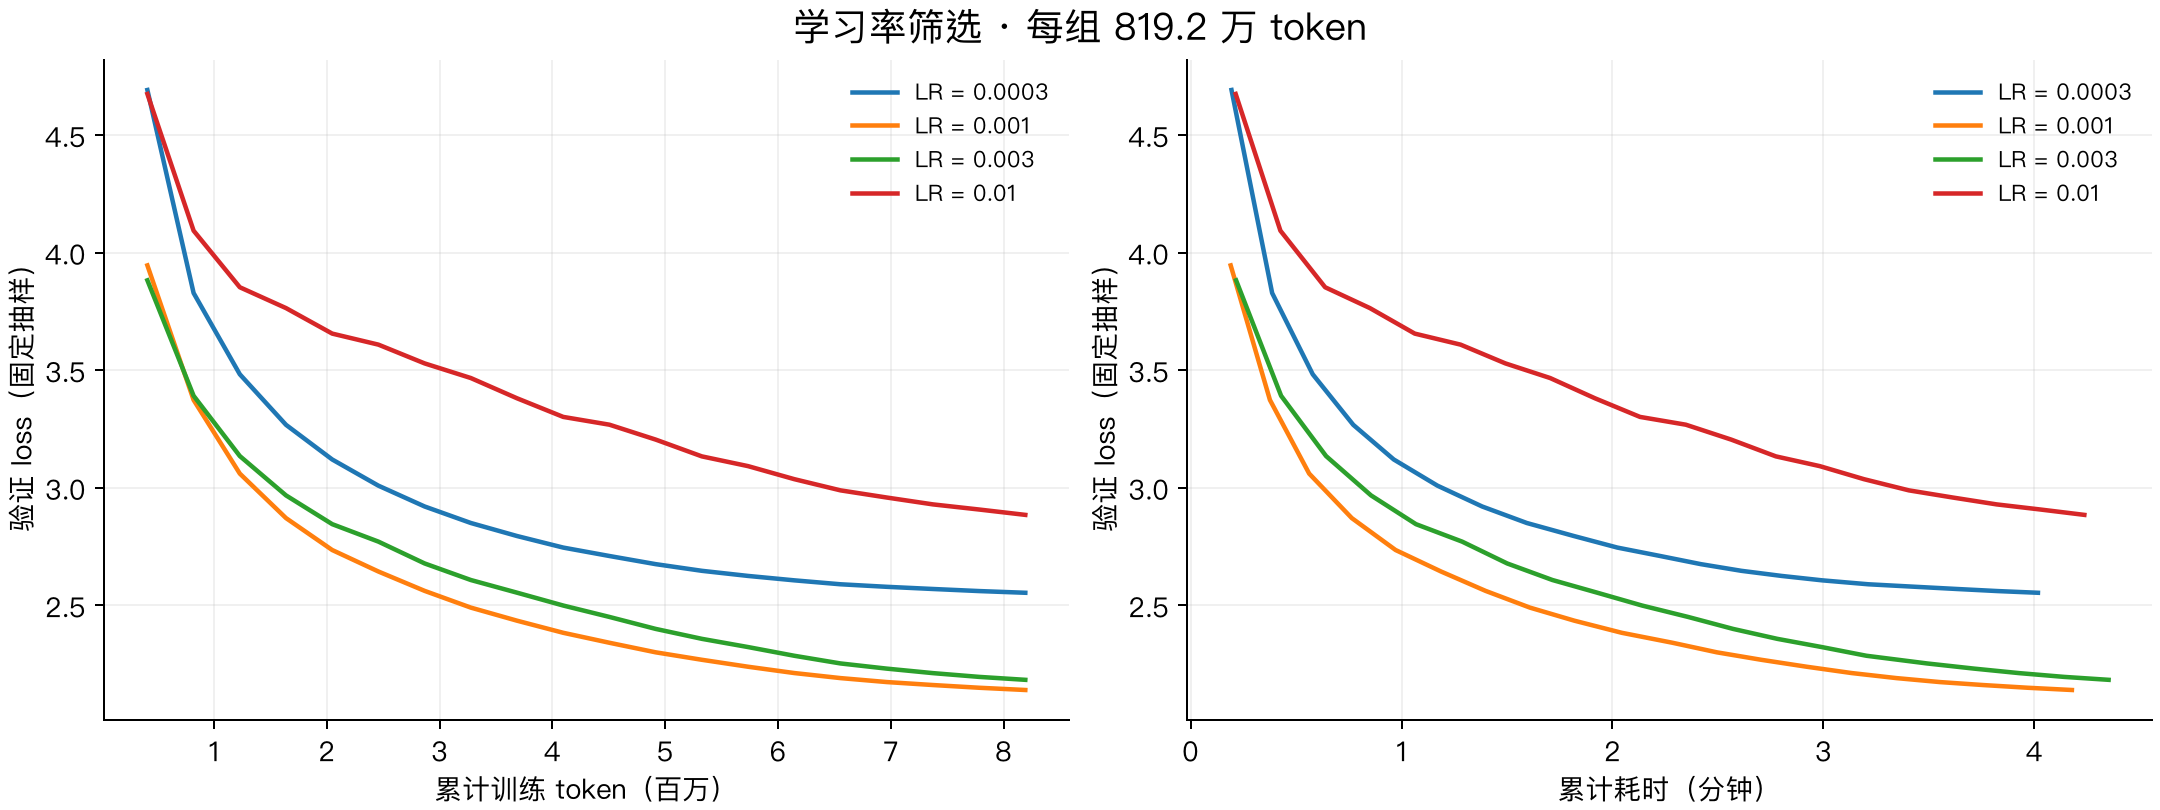
| 最大学习率 | 1,000 步后的抽样验证 loss |
|---|---|
3e-4 |
2.553 |
1e-3 |
2.140 |
3e-3 |
2.183 |
1e-2 |
2.884 |
短跑里 1e-3 最好,3e-3 也比较接近。我们再把这两档都跑到 5,000 步,训练 token 数增加到 4096 万,warmup 相应改成 100 步:
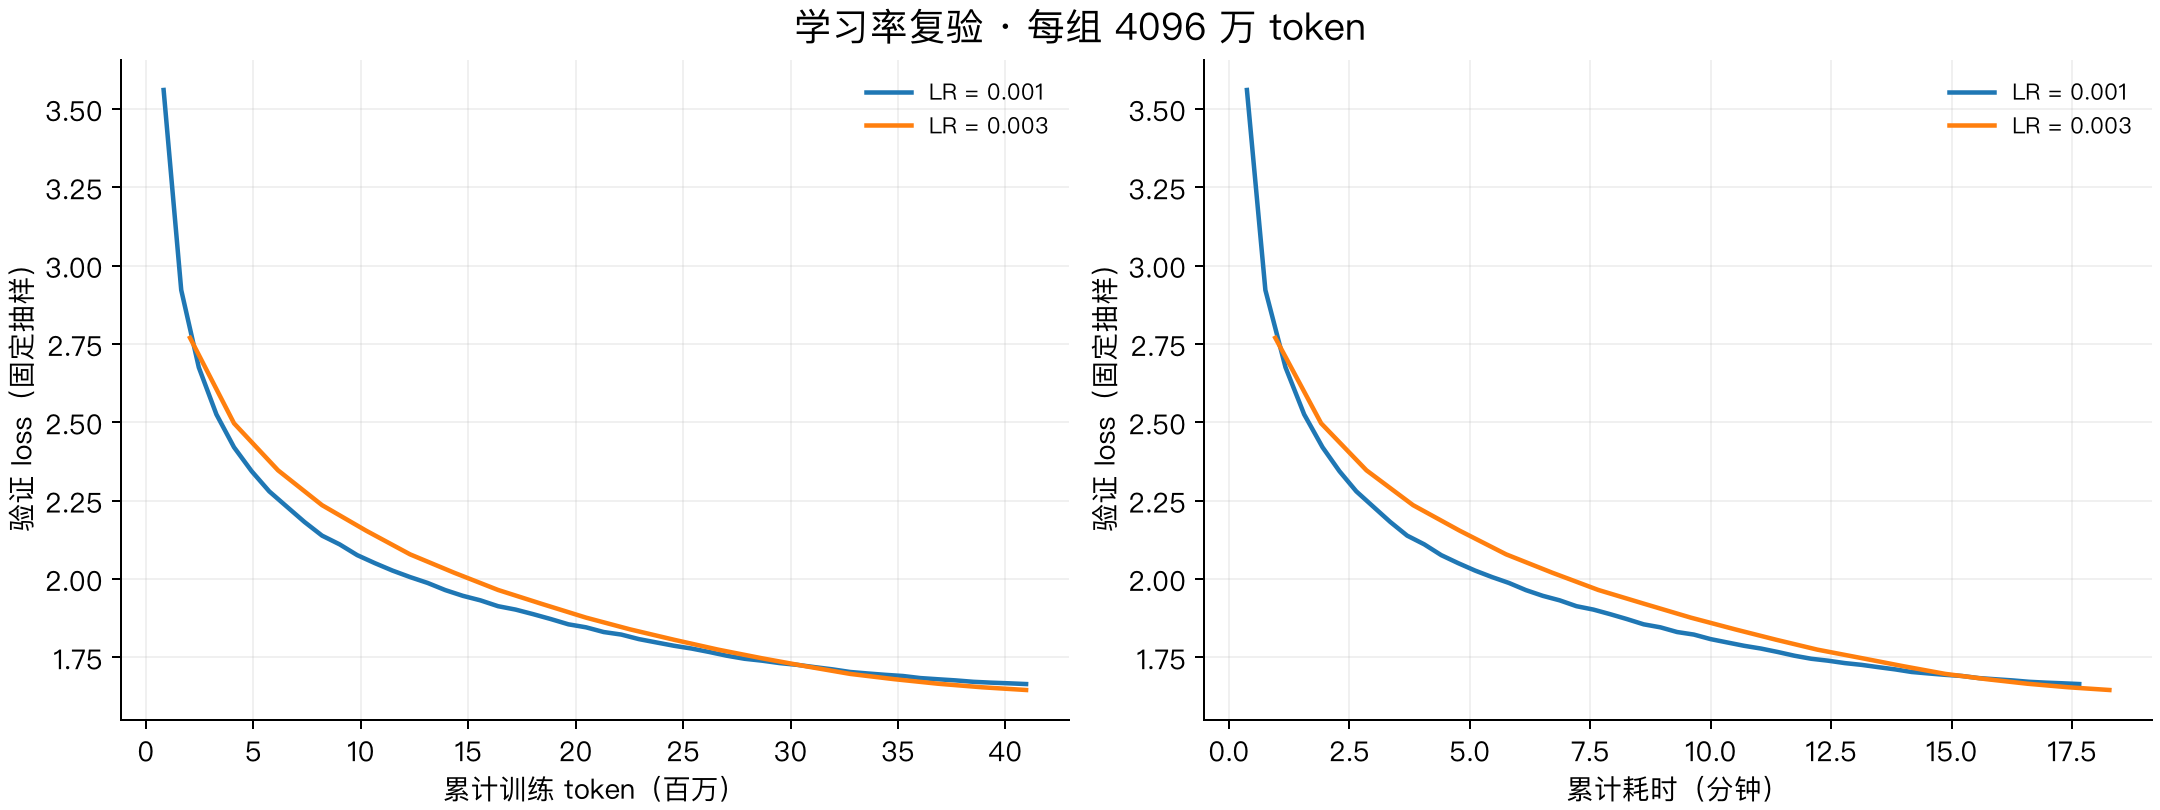
| 最大学习率 | 最终抽样验证 loss | 完整验证集 loss |
|---|---|---|
1e-3 |
1.665 | 1.673 |
3e-3 |
1.646 | 1.655 |
完整训练后,3e-3 反而略低一些。短跑可以筛掉明显不合适的参数,但前期的排序不一定就是最后的排序。下面的结构消融统一使用 3e-3,以这轮模型作为基线。
作业还要求继续增大学习率,看看什么时候会发散。我们又测了 0.03、0.1、1.0,每组最多跑 500 步;如果 loss 或梯度出现非有限值,或者训练 loss 连续 10 步超过 50,就提前停止。
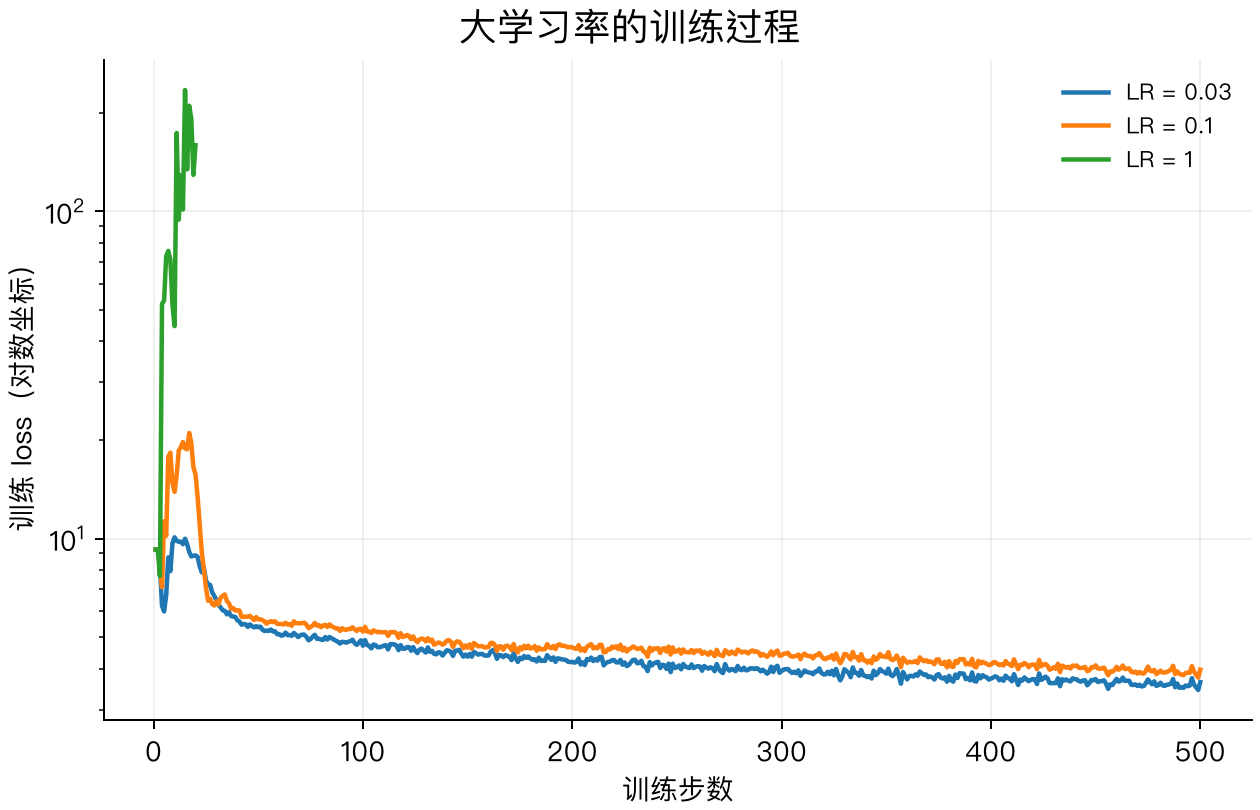
0.03 和 0.1 都跑完了,但收敛明显变慢;1.0 在第 20 步触发了停止条件。按这次的调度和判定方式,效果较好的 3e-3 距离已经观察到的发散档位还很远。实际调参时,要同时看收敛速度和最终 loss,不能只找一个“还没炸”的大学习率。
Batch size
这一组固定训练 409.6 万 token,先统一使用 3e-3 学习率,比较 batch=1、32、64、128。batch 越大,同样 token 数对应的更新次数就越少。
Studio 上还有其他服务,这次给训练进程设置了 24 GiB 的 MPS 内存预算。batch=128 能运行,256 在第一步触发内存上限;这是本次预算内的探测结果。
| Batch size | 更新次数 | 最终抽样验证 loss | 训练耗时 |
|---|---|---|---|
| 1 | 16,000 | 2.683 | 300 秒 |
| 32 | 500 | 2.499 | 125 秒 |
| 64 | 250 | 2.659 | 127 秒 |
| 128 | 125 | 3.029 | 127 秒 |
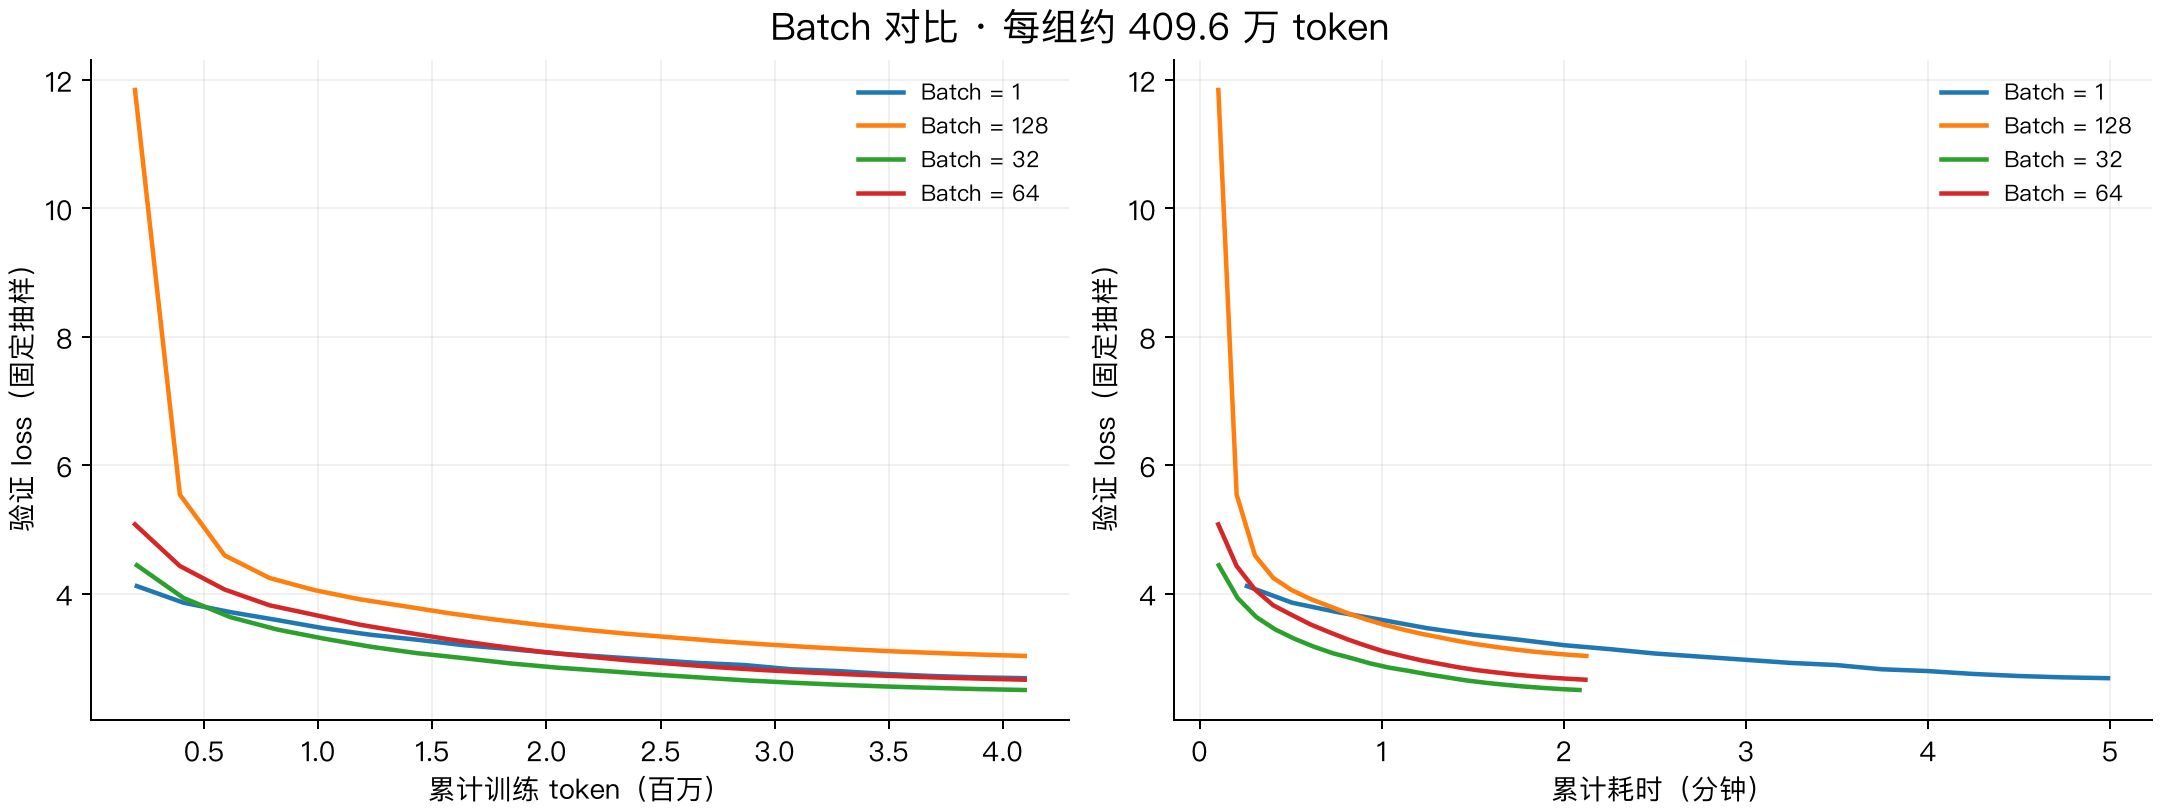
batch=1 每步只处理一条序列,算完同样的 token 花了更多时间。32 增大到 64、128 后,这次耗时没有明显下降,更新次数却继续减少,最后的 loss 更高。
学习率也可能影响这个比较,所以再补三组复验,训练 token 数不变:
| Batch size | 原学习率 → 复验学习率 | 原验证 loss → 复验 loss |
|---|---|---|
| 1 | 0.003 → 0.0005 |
2.683 → 2.541 |
| 64 | 0.003 → 0.0042 |
2.659 → 2.777 |
| 128 | 0.003 → 0.006 |
3.029 → 3.559 |
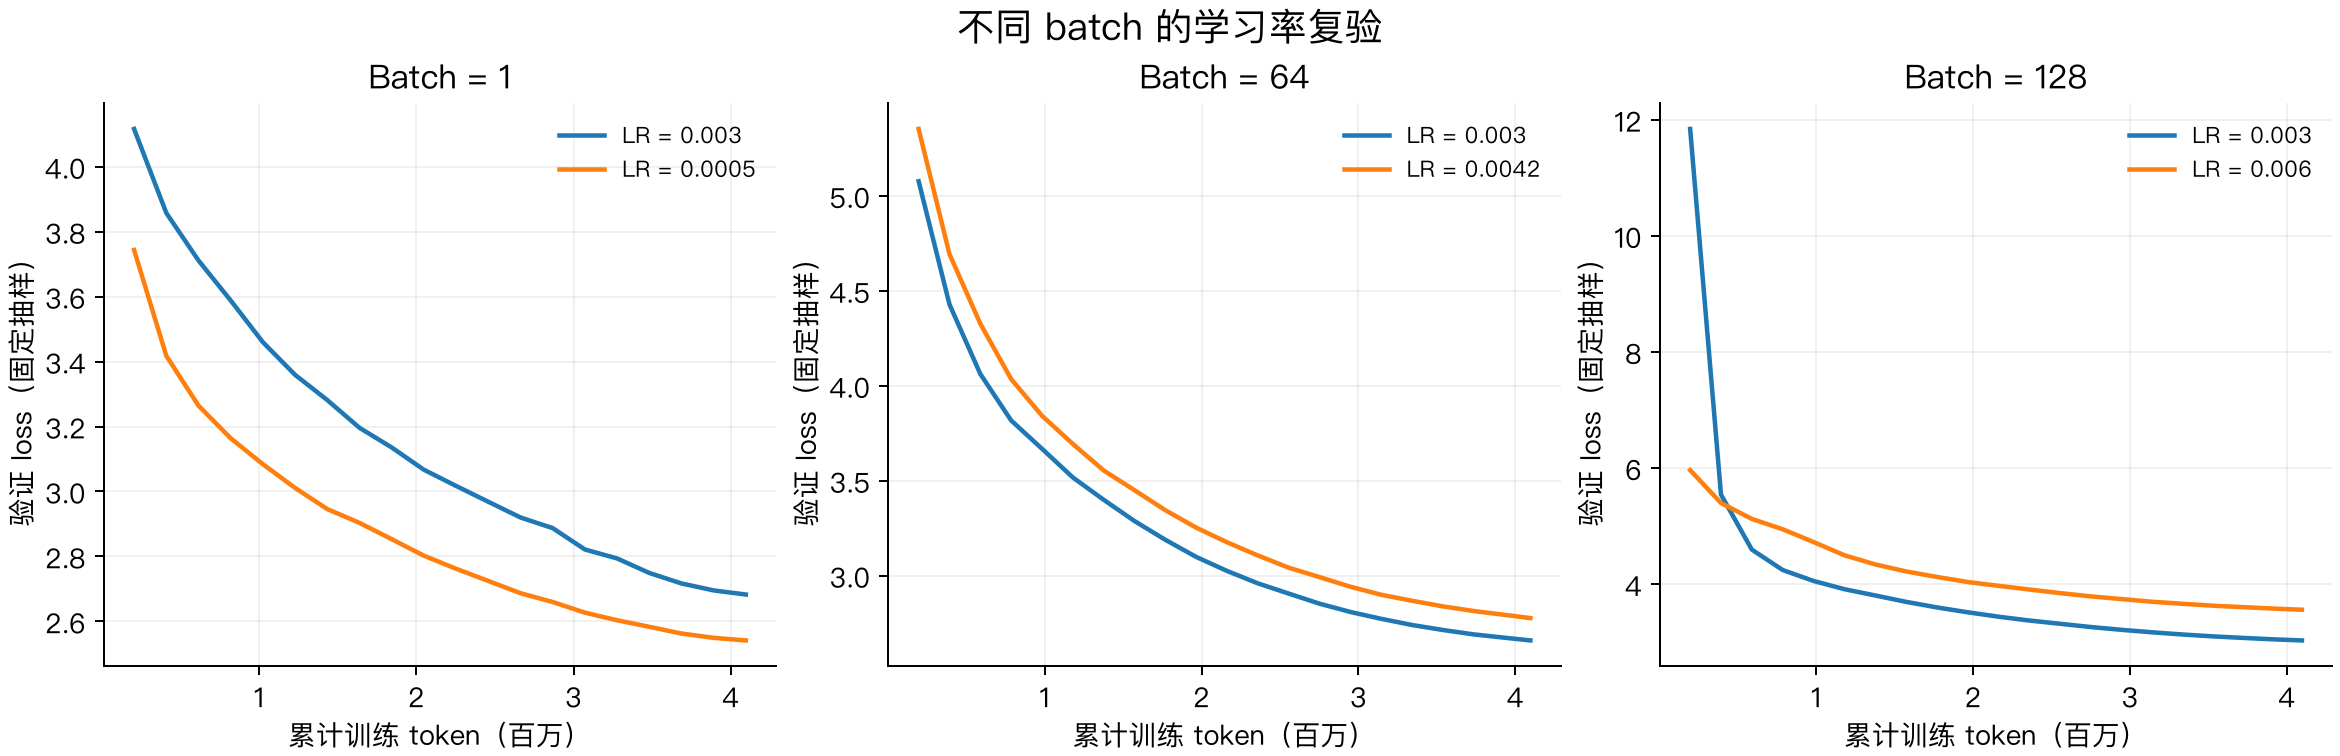
batch=1 降低学习率后有改善,但耗时仍约 299 秒;64 和 128 提高学习率后反而变差。在这次测过的配置里,batch=32 的结果最好,也更省时间,后面的主实验继续用 32。这只比较了几组配置,没有穷举每个 batch 的最优学习率。
结构消融
上一篇实现了 RMSNorm、RoPE 和 SwiGLU。把其中一个去掉或替换,其他配置保持一致,再重新训练,这种对照实验就叫消融实验。
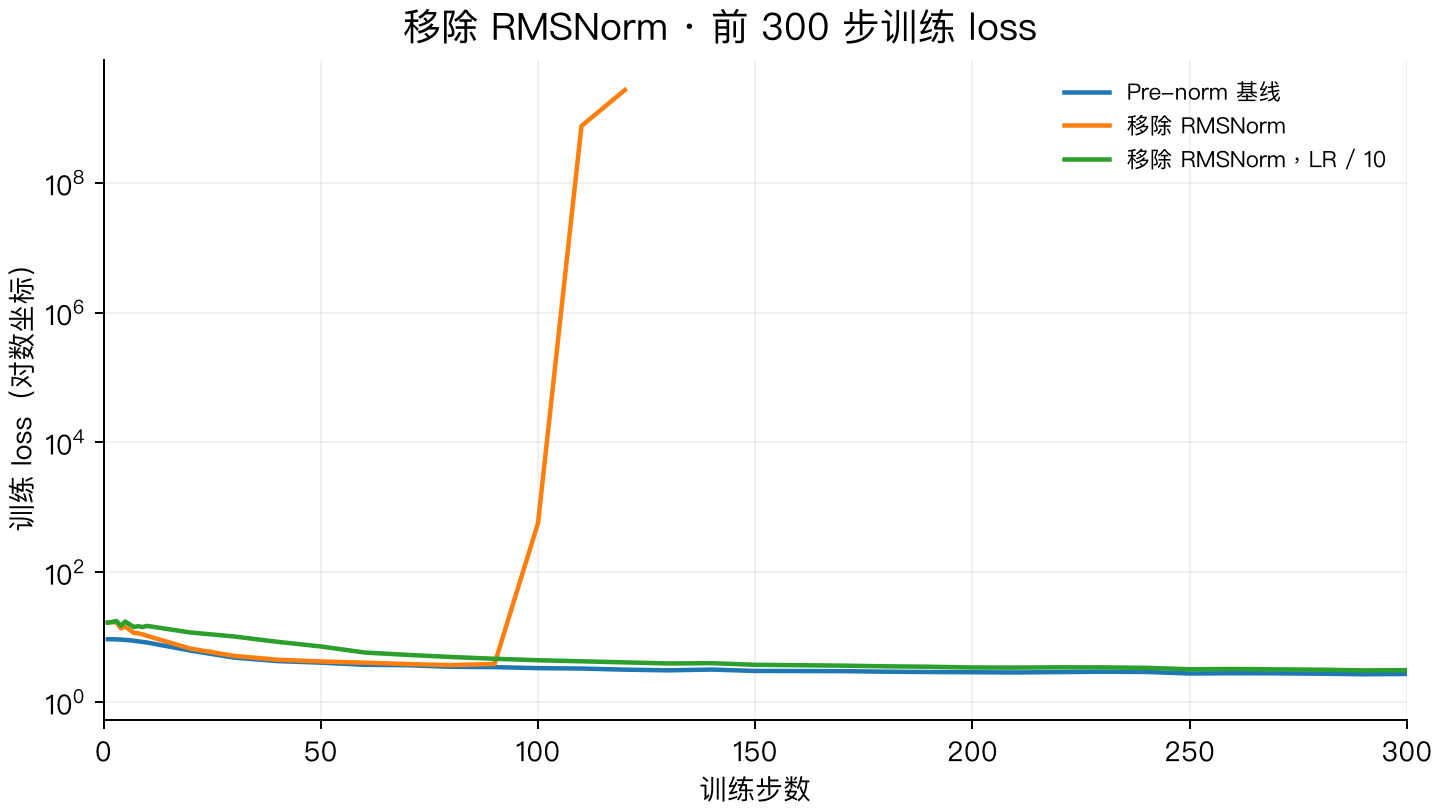
先看 RMSNorm。 把 Block 里的两次 RMSNorm 和模型末尾的 RMSNorm 全部去掉,沿用 3e-3 学习率。这一组在第 123 步触发停止条件:训练 loss 连续 10 步超过 50。
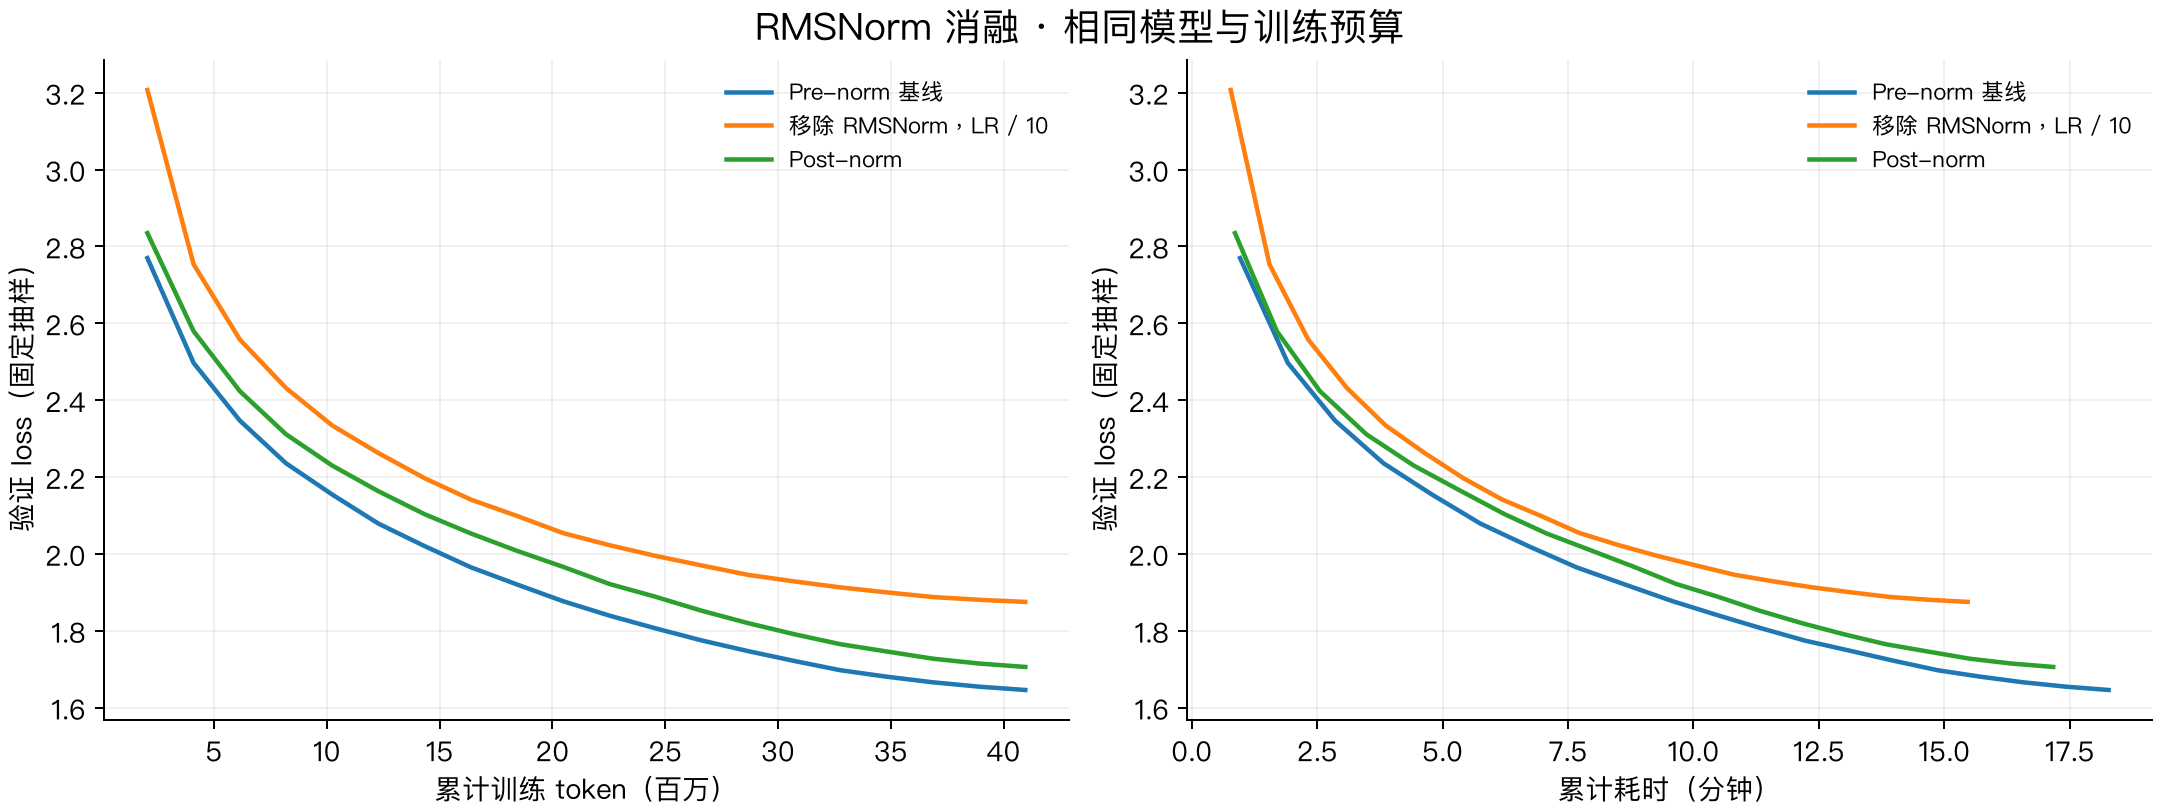
我们把学习率降到 3e-4,重新训练。这次跑完了 5,000 步,完整验证集 loss 为 1.889,仍高于基线的 1.655。因此,去掉 RMSNorm 后也能训练,但需要更小的学习率;在这次预算下,结果也更差。
然后把 pre-norm 改成 post-norm,也就是把归一化移到残差相加之后:
这里保留模型末尾的 RMSNorm,只移动 Block 内的两次归一化。两组都训练 4096 万 token,完整验证集 loss 如下:
| 归一化位置 | 验证 loss |
|---|---|
| Pre-norm | 1.655 |
| Post-norm | 1.716 |
在这组配置下,pre-norm 的结果更好,后面的实验继续保留原来的归一化位置。
再看 RoPE。 去掉 Q、K 的旋转,保留 causal mask,同样训练 4096 万 token。完整验证集 loss 从基线的 1.655 升到了 1.836。模型仍然能收敛,但这次去掉 RoPE 后效果变差了。
这里没有显式位置编码,但 causal mask 仍然让不同位置能看到的前缀不同,所以不能说模型完全没有位置信息。
最后看 SwiGLU。 去掉门控分支,换成两层 Linear 加 SiLU:
这次要一起调整隐藏层维度。SwiGLU 有三张权重矩阵,参数量约为 d_ff 设成 4 × d_model,让两种结构的参数量接近,再比较效果。
这两组和基线的结果如下,训练预算都是 4096 万 token:
| 结构 | 参数量 | 完整验证集 loss |
|---|---|---|
| RoPE + SwiGLU(基线) | 22,696,448 | 1.655 |
| 去掉 RoPE | 22,696,448 | 1.836 |
| SwiGLU 换成 SiLU | 22,827,520 | 1.649 |
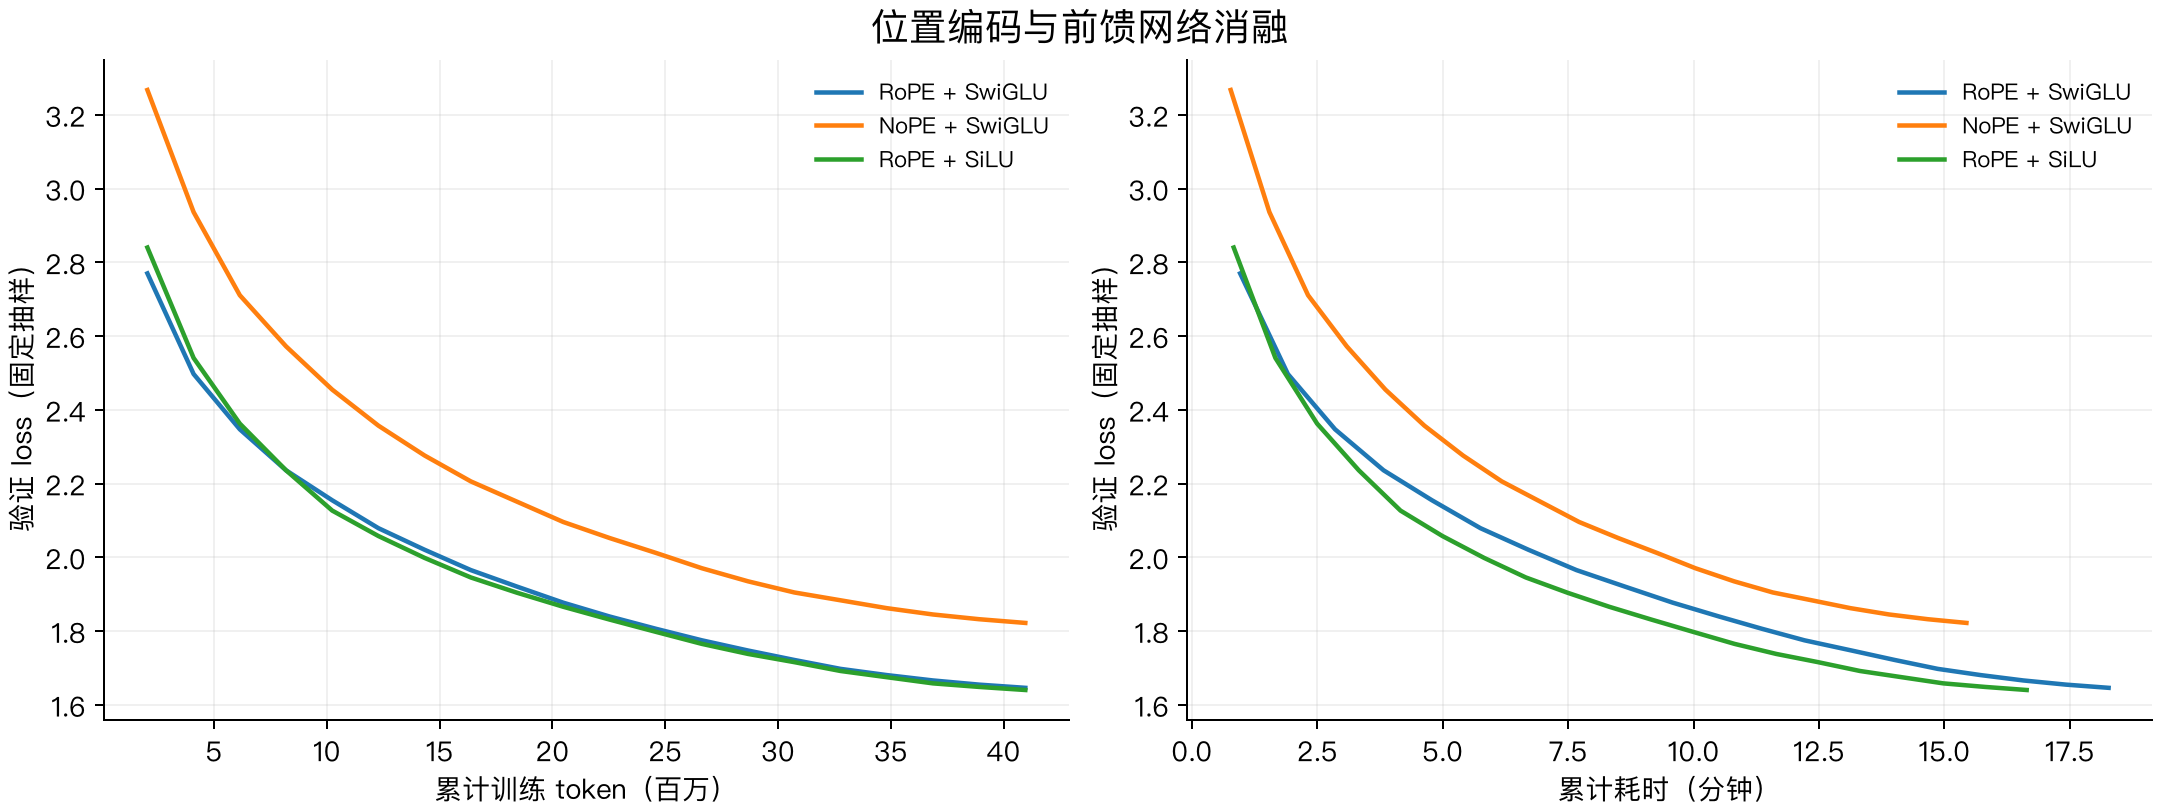
去掉 RoPE 后,loss 的差距比较明显。SiLU 与 SwiGLU 则很接近,SiLU 在这次训练里低了约 0.005,不能据此认定它普遍更好。这里每组只跑了一个随机种子,比较的是这套小模型、数据和训练预算下的结果。
OpenWebText
TinyStories 跑通后,再换成 OpenWebText。它包含更多样的网页文本,主题、词汇和写作方式都更复杂。
这一组使用作业提供的 OpenWebText 样本。BPE 仍然只用训练集前 10,000 篇文档训练,词表大小为 10,000;完整编码后,训练集有 3,093,222,999 个 token,验证集有 75,330,294 个 token。
模型结构保持不变,batch=32,学习率 3e-3,训练 5,000 步,共处理 4096 万 token。
这轮训练用了约 17 分 17 秒,最终抽样验证 loss 为 4.083。随后遍历完整验证集的 75,330,048 个 token,得到 loss 4.068,PPL 约 58.43。
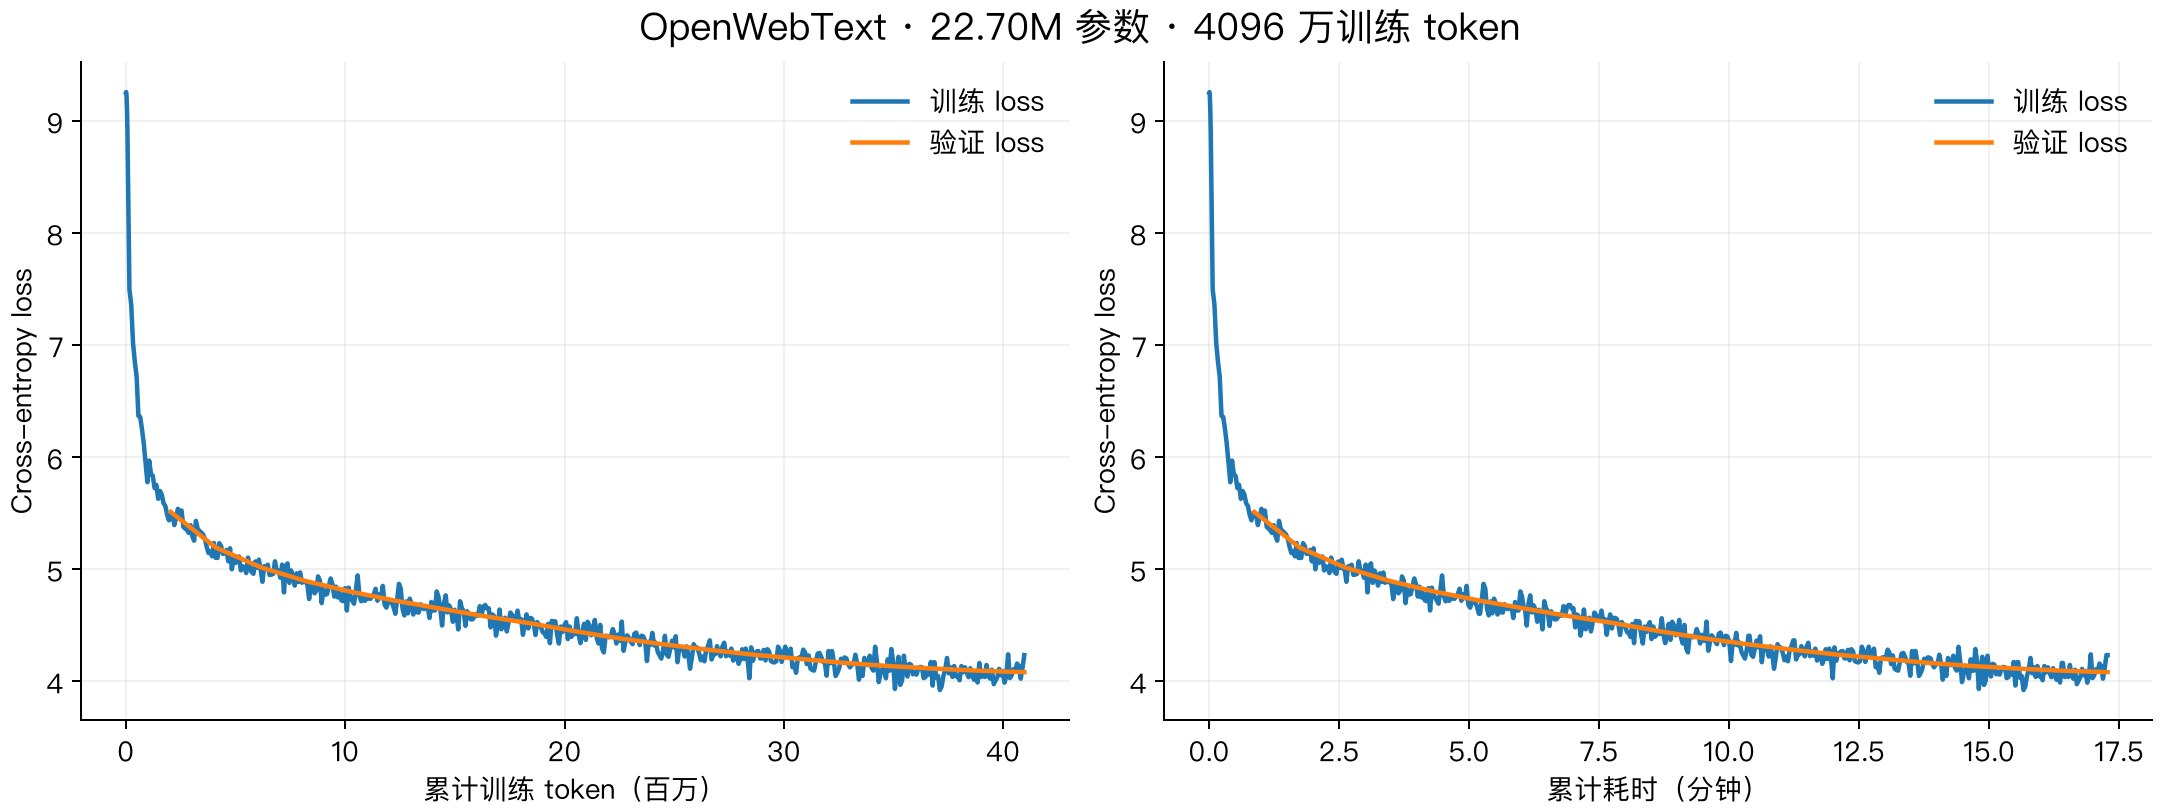
两份数据上的 loss 不能直接比较模型能力:数据分布不同,使用的 tokenizer 也不同。下面用 temperature=0.8、top-p=0.9、seed=42,从同一个开头生成 256 个新 token,原始输出如下。里面的人名、事件都是模型续写,不能当成事实:
The future of technology depends on our impact on the U.S. economy.
The U.S. Congress-backed President Obama, it would be “failed” to the American people. But it would be that he would be part of the White House.
Trump made a speech about Trump’s Senate GOP plan. In the last few months, it would become increasingly difficult to analyze their plan.
“I’m going to start to show that he should make a certain ground for our public is to write a lot of things,” said Dynne Maddam, an Obama and the White House. “But I do think we are going to make sure that we’ll actually have to do that, and I’m sure we’re going to go into the U.S. Constitution. So we have to get rid of our American people.”
Surely, Trump’s plans to ensure that the White House will be in full responsibility for the United States and the White House.
Trump has also been a part of a Senate Democratic nomination. He has a righteous run for the White House and has been very active in the American community, and he was well called for.
“We’re not talking
句子已经有网页文章的样子,但开头还在说技术,后面马上跳到政治人物和白宫,语法和逻辑也有不少问题。贪心解码更容易重复,连续多段都在写 “The new technology will be able to create a new technology”。
这次只有约 2270 万参数和 4096 万训练 token,在 TinyStories 上已经能写短故事,换成内容更复杂的网页文本后,还远没有达到流畅、连贯的程度。
权重共享
最后试一下让输入 Embedding 和输出 LM head 共享权重。它们都是 vocab_size × d_model 的矩阵,共享后能省掉
这里单独做一组对照:先把两张矩阵都初始化成同一组数值,标准差设为 0.02。控制组保留两个独立参数,共享组则让它们指向同一个参数对象。两组都训练 4096 万 token,其他配置相同。
| 配置 | 参数量 | 完整验证集 loss | 训练耗时 |
|---|---|---|---|
| 不共享权重 | 22,696,448 | 1.676 | 16 分 43 秒 |
| 共享权重 | 17,576,448 | 1.650 | 16 分 43 秒 |
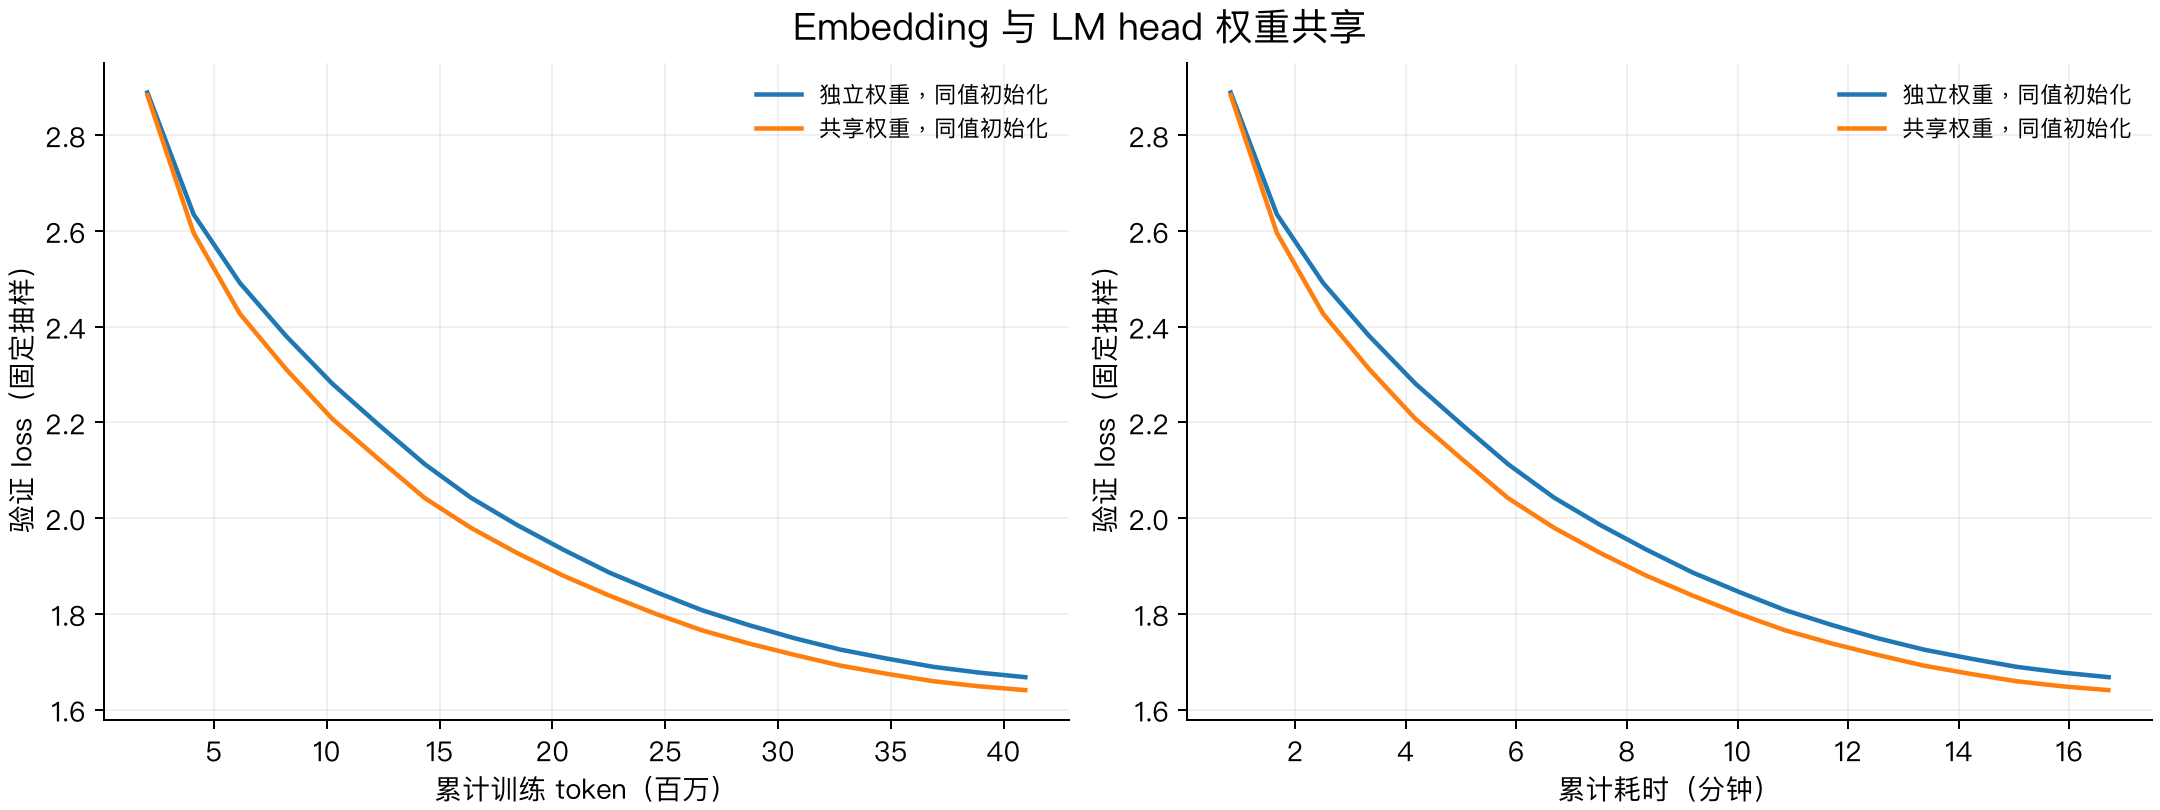
共享后少了 10000 × 512 = 5120000 个参数,约占原模型的 **22.6%**。按前面的 float32 参数、梯度和 AdamW 两份状态计算,能省约 81.92 MB。这次训练耗时基本一样,验证 loss 还略低一些,对这组小模型来说是个可以保留的改动。
后记
写到这里,上一篇搭好的 Transformer 就真正训练起来了。从计算 loss、更新参数,到保存模型、生成文本,Assignment 1 的训练流程也就串起来了。TinyStories 上已经能续写短故事,不过重复和前后矛盾仍然存在,模型规模和训练量也都还很小。
后面继续写训练优化,看看训练时间和内存具体花在哪里,以及怎么让同样的硬件跑得更快。
参考资料: